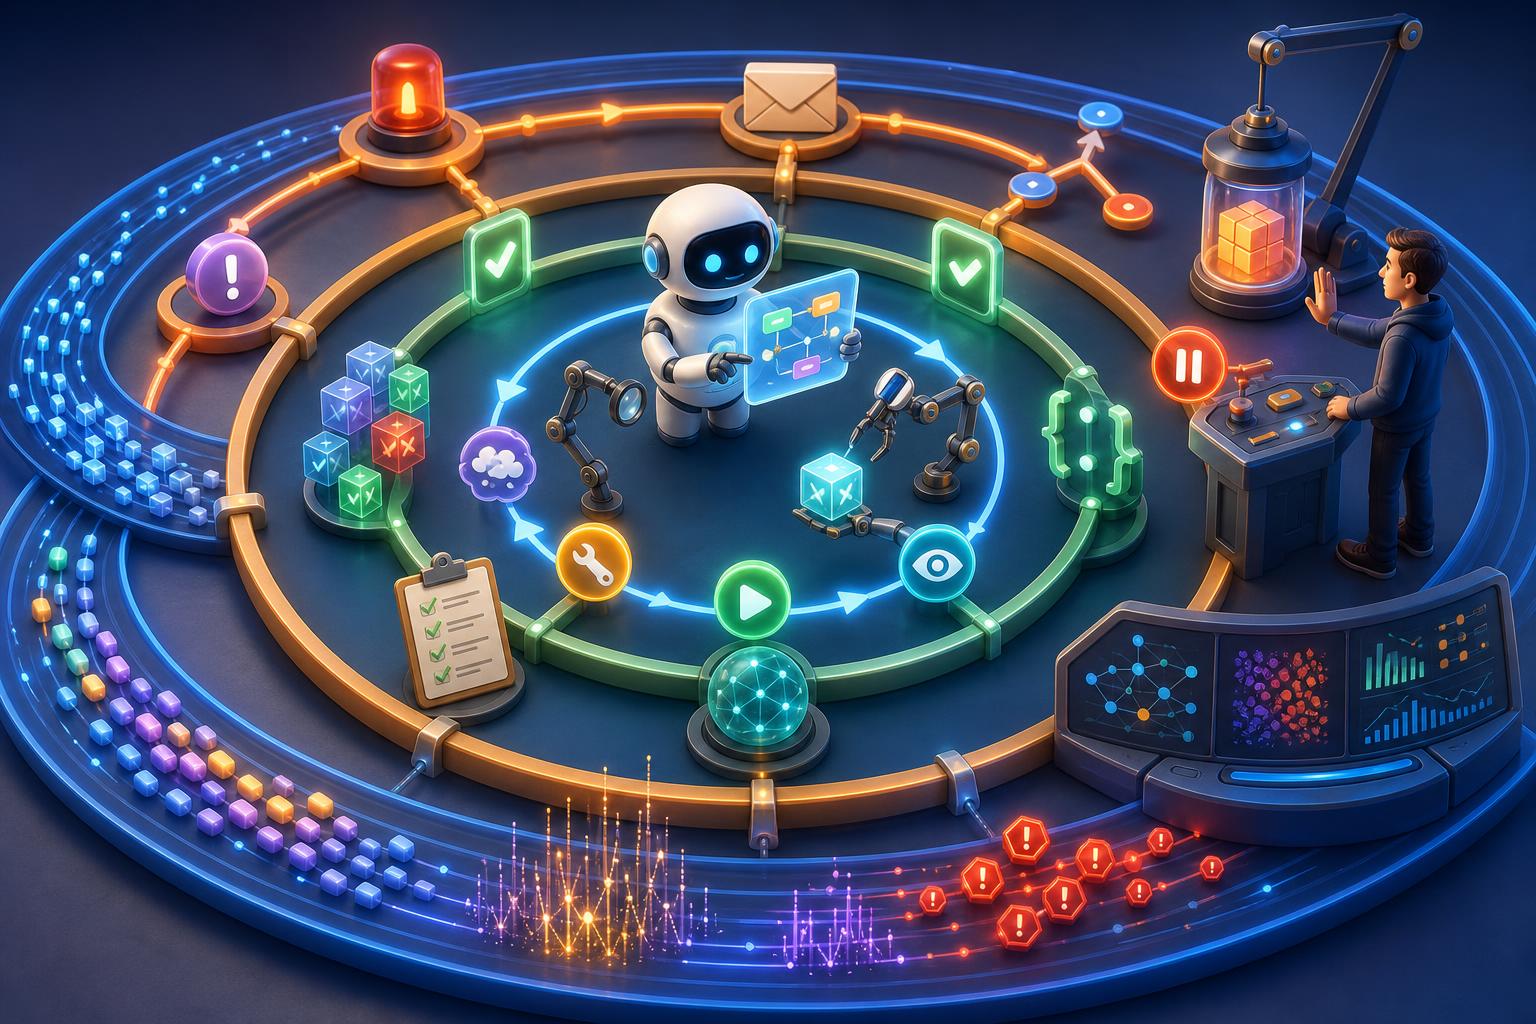
Loop engineering adalah pendekatan untuk merancang AI agent sebagai sistem yang bekerja melalui beberapa siklus pemeriksaan dan perbaikan, bukan sekadar pola satu kali prompt lalu satu kali jawaban. Dalam kerangka ini, agent tidak dianggap selesai hanya karena model berhenti menghasilkan teks, melainkan karena hasilnya lolos verifikasi, sesuai tujuan, aman dijalankan, dan dapat ditingkatkan dari riwayat eksekusi sebelumnya [1]. Di ekosistem LangChain, gagasan ini penting karena agent modern pada praktiknya adalah kombinasi antara model, tools, aturan alur, observability, evaluasi, dan mekanisme human approval [1][2].
Secara konseptual, loop engineering dapat dipahami sebagai lapisan yang saling membungkus. Lapisan paling dasar adalah core agent loop, lalu di atasnya ada verification loop, pola workflow yang terhubung ke kejadian nyata, dan outer loop untuk self-improvement berbasis trace [1]. Perlu dicatat, istilah loop engineering lebih tepat diposisikan sebagai pendekatan desain agent dalam ekosistem LangChain dan LangSmith, bukan sebagai standar formal yang sudah mapan secara akademik. Karena itu, pembahasannya sebaiknya dilihat sebagai praktik rekayasa sistem AI yang production-ready [1].
Pada level pertama, core agent loop adalah siklus inti ketika model menerima konteks, memahami tujuan, memilih tool, menjalankan tool, membaca hasilnya, lalu memutuskan langkah berikutnya sampai tugas dianggap selesai. Pola ini sejalan dengan definisi agent di LangChain sebagai “model + harness”, yaitu model yang dibungkus konfigurasi prompt, tools, dan middleware agar dapat bertindak sebagai agent [2]. Untuk kebutuhan yang sederhana, pendekatan seperti create_agent cukup mewakili loop inti tersebut [2].
Namun, core agent loop saja belum menjamin hasilnya benar. Agent bisa berhenti terlalu cepat, salah memakai tool, keliru mengisi parameter, atau menyimpulkan tugas selesai tanpa validasi memadai. Inilah alasan verification loop menjadi penting. Dalam loop ini, hasil agent dievaluasi terhadap goal, rubric, atau acceptance criteria yang jelas. Dokumentasi evaluasi LangSmith mendukung pendekatan ini melalui alur resmi berupa pembuatan dataset, definisi evaluator, eksekusi experiment, dan analisis hasil [5]. Dengan kata lain, definisi selesai bergeser dari “model merasa sudah selesai” menjadi “hasil telah memenuhi kriteria evaluasi” [1][5].
Verification loop tidak harus selalu memakai model AI. Evaluator dapat berupa pemeriksaan deterministik, misalnya apakah unit test lulus, schema valid, format JSON benar, atau status HTTP sesuai harapan [5]. Untuk aspek semantik, penilaian dapat memakai pendekatan LLM-as-a-judge, misalnya menilai apakah penjelasan cukup jelas atau solusi benar-benar sesuai requirement [5]. Selain itu, evaluasi manusia tetap relevan, terutama untuk perubahan berisiko tinggi seperti modifikasi arsitektur, transaksi, atau akses sensitif. Karena itu, pendekatan paling realistis di produksi biasanya adalah kombinasi deterministic checks, evaluator berbasis LLM, dan human review [4][5].
Hal penting lain adalah membedakan output evaluation dan trajectory evaluation. Output evaluation hanya memeriksa hasil akhir, sedangkan trajectory evaluation menilai jalur keputusan agent, termasuk pemakaian tool, urutan langkah, dan kepatuhan terhadap batas keamanan [5]. Dalam sistem agentic, trajectory evaluation sangat penting karena output akhir bisa saja tampak benar, tetapi prosesnya salah atau tidak aman. Misalnya, agent mungkin memperoleh jawaban yang benar setelah mengakses tool yang tidak seharusnya dipakai. Dari sudut pandang engineering, itu tetap merupakan kegagalan [5].
Lapisan berikutnya adalah pola workflow yang sering dijelaskan sebagai event-driven loop. Dalam sumber resmi yang tersedia, ini lebih aman dipahami bukan sebagai fitur produk tunggal bernama demikian, melainkan sebagai pola arsitektur di atas runtime yang stateful dan dapat diinterupsi [3]. LangGraph secara eksplisit diposisikan sebagai framework orkestrasi low-level untuk workflow dan agent yang long-running serta stateful [3]. Artinya, agent tidak harus hidup dalam pola “satu prompt masuk, satu jawaban keluar”, tetapi bisa dipicu oleh kejadian eksternal seperti issue baru, kegagalan pipeline, atau permintaan review, lalu melanjutkan state dari titik sebelumnya [3].
Di sinilah LangGraph menjadi relevan. Jika LangChain cocok untuk membangun harness dasar agent, maka LangGraph lebih tepat dipakai ketika tim membutuhkan retry, persistence, kontrol alur, interupsi, dan penggabungan langkah deterministik dengan langkah agentic [2][3]. Secara praktis, ini memungkinkan alur seperti: event diterima, agent menganalisis konteks, tool dijalankan beberapa kali, sistem berhenti untuk approval, lalu eksekusi dilanjutkan setelah keputusan datang. Pendekatan ini sangat berguna untuk integrasi dunia nyata yang menuntut kontrol lebih besar daripada sekadar tool-calling sederhana [3][4].
Aspek human-in-the-loop memperkuat lapisan ini, terutama untuk write actions atau tindakan sensitif. Dokumentasi resmi LangChain menjelaskan bahwa middleware human-in-the-loop dapat menambahkan oversight manusia pada tool call agent [4]. Bila model mengusulkan tindakan yang perlu review, seperti menulis file atau mengeksekusi SQL, runtime dapat menginterupsi eksekusi, menyimpan state, lalu menunggu keputusan manusia [4]. Keputusan tersebut dapat berbentuk approve, edit, reject, atau respond [4]. Ini menunjukkan bahwa otomatisasi dalam agent tidak identik dengan menghapus manusia, melainkan memindahkan manusia ke titik kontrol yang paling penting.
- Read-only actions lebih aman untuk diotomatisasi, misalnya membaca log, menganalisis kode, atau menyusun ringkasan.
- Write actions perlu guardrail lebih ketat, misalnya perubahan file, eksekusi query non-SELECT, deployment, atau pengiriman tindakan yang berdampak langsung [4].
Lapisan terluar adalah self-improvement loop atau hill-climbing loop. Gagasan intinya: setiap eksekusi agent menghasilkan trace, lalu trace tersebut dianalisis untuk menemukan pola kegagalan dan peluang perbaikan [1]. Dalam artikel resmi LangChain, loop ini dijelaskan sebagai mekanisme yang memakai trace untuk memahami apa yang berjalan baik, apa yang gagal, dan bagaimana harness dapat ditulis ulang agar performanya meningkat [1]. Yang diperbaiki tidak selalu modelnya. Sering kali peningkatan terbesar justru datang dari prompt yang lebih jelas, deskripsi tool yang lebih spesifik, schema input yang lebih ketat, strategi retrieval yang lebih tepat, atau workflow yang lebih disiplin.
Peran trace sangat penting karena tanpa observability, tim hanya melihat output akhir. Padahal masalah dapat muncul pada banyak titik: prompt tidak jelas, konteks kurang, tool dipilih keliru, parameter salah, model salah menafsirkan observation, atau agent berhenti terlalu cepat. LangSmith menyediakan fondasi observability dan tracing untuk menangkap input, output, metadata, child runs, tool calls, timing, token, biaya, serta error, sehingga perilaku agent dapat diinspeksi secara rinci [5]. Dengan data itu, tim dapat mengubah kegagalan abstrak menjadi temuan teknis yang bisa diperbaiki.
Di sinilah LangSmith Engine paling dekat dengan ide loop engineering. Berdasarkan catatan riset yang merujuk artikel resmi dan halaman produk terkait, Engine diposisikan untuk menganalisis trace, mencari pola unmet expectations atau kegagalan agent, mengelompokkan issue serupa, lalu mengusulkan perbaikan terhadap harness [1]. Secara editorial, posisi yang paling aman adalah menyebutnya sebagai alat analisis trace dan pengusul perbaikan, bukan sistem yang bebas memperbaiki dirinya sendiri tanpa kontrol. Perubahan tetap idealnya diuji lewat evaluasi dan direview manusia sebelum diterapkan ke produksi [1][5].
Fokus engineering dengan demikian bergeser. Tim tidak lagi cukup hanya “menulis prompt yang bagus”, tetapi harus merancang keseluruhan harness agent:
- prompt dan instruksi sistem,
- tool definitions dan tool descriptions,
- workflow stateful dan retry policy,
- human approval untuk aksi sensitif,
- dataset evaluasi dan evaluator,
- tracing, observability, serta regression testing [2][3][4][5].
Jika dirangkum pada stack LangChain, pembagian perannya cukup jelas. LangChain menyediakan titik masuk untuk membangun core agent loop melalui harness yang dapat dikustomisasi [2]. LangGraph memberi fondasi untuk workflow stateful, durable execution, persistence, dan human-in-the-loop [3][4]. LangSmith menyediakan observability, tracing, dataset, evaluator, dan experiment agar kualitas agent dapat diukur secara sistematis [5]. Lalu LangSmith Engine memperkuat outer loop dengan analisis trace dan usulan fix agar harness membaik dari waktu ke waktu [1].
Kesimpulannya, loop engineering adalah cara berpikir yang lebih matang dalam membangun AI agent. Agent production-ready bukan hanya soal model yang mampu memilih tool, melainkan soal bagaimana sistem mengeksekusi tugas, memverifikasi hasil, terhubung ke operasi nyata, lalu belajar dari trace kegagalannya [1]. Dalam konteks LangChain, kombinasi LangChain, LangGraph, LangSmith, dan LangSmith Engine menunjukkan bahwa keandalan agent lahir dari desain loop yang berlapis, bukan dari satu prompt atau satu model semata [1][2][3][5].