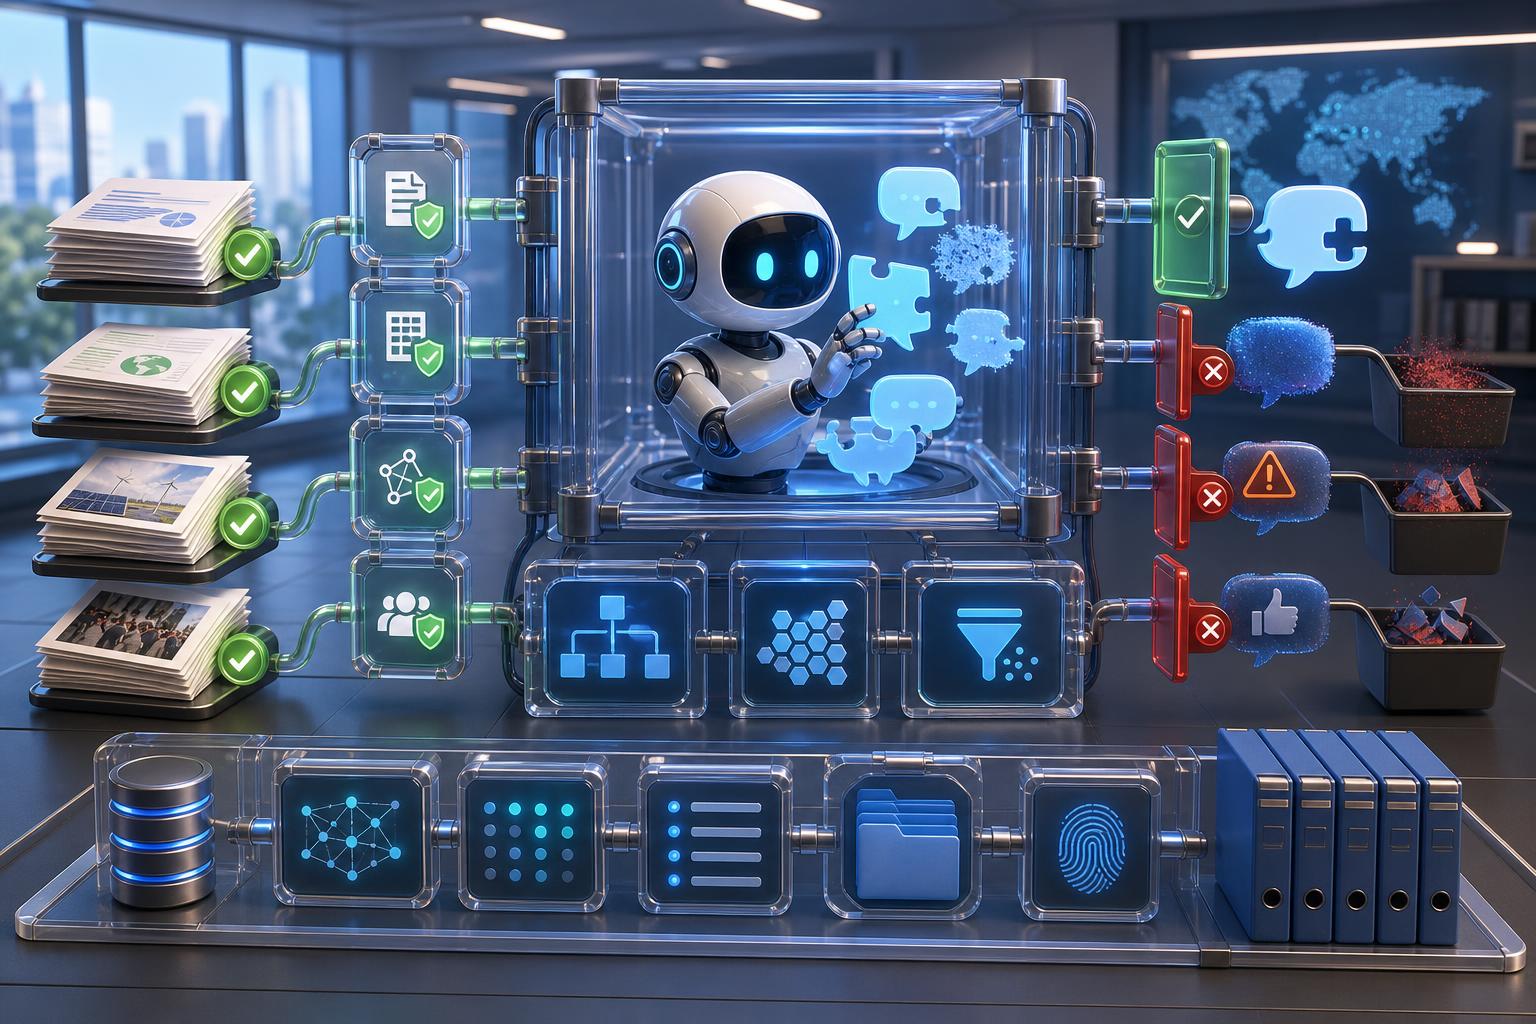
Paper From Prompts to Contracts: Harness Engineering for Auditable Enterprise LLM Agents menawarkan kontribusi yang menarik karena tidak berusaha memperkenalkan model bahasa baru, melainkan menggeser pusat pembahasan ke rekayasa sistem. Dalam konteks aplikasi enterprise, penulis berangkat dari masalah yang sangat nyata: banyak aplikasi LLM lahir sebagai prototipe yang perilakunya “ditopang” oleh prompt dan konteks retrieval, tetapi ketika masuk ke tahap produksi, organisasi membutuhkan batas sumber, routing entitas, kontrak jawaban, serta jejak eksekusi yang dapat direproduksi dan diaudit [1][2]. Dari sudut pandang rekayasa perangkat lunak, reposisi ini penting karena pertanyaan utamanya bukan lagi “seberapa patuh model pada instruksi?”, melainkan “bagian mana dari perilaku sistem yang benar-benar dapat dijamin dan diverifikasi?” [2].
Gagasan utama paper ini adalah pendekatan harness engineering. Secara ringkas, perilaku yang deterministik dipindahkan dari prompt ke lapisan yang dimiliki kode: manifest, skema, validator, dan artefak trace yang mengelilingi sebuah composition boundary yang dapat diganti modelnya [1][2]. Di desain ini, LLM diposisikan terutama sebagai mesin komposisi bahasa, sedangkan kontrol atas kelayakan sumber, routing entitas, promosi klaim, perencanaan jawaban, hingga pembentukan trace berada di lapisan harness [2][3]. Bagi pembaca enterprise, ini adalah proposisi yang kuat karena auditability diperlakukan sebagai properti sistem, bukan sebagai sifat bawaan model.
Implementasi referensi paper memakai irisan data publik dari lima grup korporasi Korea dengan total 25 perusahaan tercatat dan 113 source-backed runtime claims [1][2]. Sumber utamanya berasal dari OpenDART dan materi hubungan investor resmi, sedangkan sinyal pasar dan berita diperlakukan terutama sebagai runtime signals, bukan otomatis menjadi klaim yang boleh dijawab sebagai fakta [2][5]. Pilihan dataset ini relevan untuk pembuktian konsep karena domainnya cukup terstruktur untuk menguji keterikatan jawaban terhadap sumber publik yang terdaftar. Namun, penting dicatat sejak awal bahwa ruang uji ini tetap sempit dan terkurasi; karena itu, kekuatan utama paper ada pada pola arsitekturalnya, bukan pada klaim generalisasi lintas domain yang luas [1][2].
Penulis merumuskan tiga pertanyaan riset yang jelas. Pertama, apakah harness dapat mempertahankan kontrak sistem pada skenario validasi yang tetap? Kedua, apakah jaminan tersebut tetap berlaku saat model di composition boundary diganti? Ketiga, apakah jaminan itu benar-benar berasal dari lapisan enforcement yang dimiliki kode, bukan sekadar dari prompt yang ditulis lebih ketat? [2] Struktur evaluasi ini membuat paper terasa rapi, karena kontribusinya tidak disamarkan sebagai “model lebih pintar”, melainkan diuji sebagai mekanisme kontrol yang bisa diinspeksi.
Pada RQ1, hasil yang dilaporkan cukup meyakinkan untuk ruang lingkup yang mereka tetapkan. Harness mempertahankan kontrak source grounding, entity routing, kelengkapan trace, output hygiene, dan kontrol atas bahasa rekomendasi dalam skenario validasi tetap [1][2]. Nilai tambah pentingnya adalah adanya fault injection sebagai negative control: tujuh mutasi kontrak yang sengaja dirusak seluruhnya berhasil ditandai validator, yaitu 7 dari 7 kasus [1]. Ini memberi bobot empiris pada klaim bahwa validator bukan sekadar formalitas dokumentasi, melainkan benar-benar bekerja ketika kontrak sistem dilanggar.
Pada RQ2, paper menguji ketahanan harness terhadap substitusi model. Tiga model yang dipakai adalah Claude Sonnet 4, GPT-4.1 mini, dan Gemini 2.5 Flash, diuji pada 30 skenario dengan 3 pengulangan, sehingga totalnya 270 runs [1]. Temuan yang paling penting bukan bahwa semua keluaran model selalu baik, melainkan bahwa semua code-owned checks yang dimiliki harness lolos pada seluruh 270 run [1]. Saat ada kelemahan di sisi keluaran yang dikomposisi model, kegagalan itu tertangkap dan tercatat oleh mekanisme harness [1][2]. Ini menunjukkan pemisahan tanggung jawab yang matang: model boleh bervariasi kualitasnya, tetapi lapisan kontrol tetap stabil.
Angka rinci pada RQ2 justru memperkuat kredibilitas paper karena penulis tidak menutupi keterbatasan model. Validitas first-pass live output tercapai pada 234 dari 270 run, referensi terhadap source-claim yang dipilih harness muncul pada 252 dari 270 run, dan struktur jawaban yang diwajibkan dipakai pada 250 dari 270 run [1]. Secara analitis, angka-angka ini penting karena memperlihatkan bahwa paper tidak sedang menjual ilusi “LLM selalu patuh”. Sebaliknya, kontribusinya ada pada pemisahan yang tegas antara apa yang dapat dijamin oleh harness dan apa yang tetap rapuh di sisi komposisi model [1][2]. Bagi organisasi, kejujuran seperti ini lebih berguna daripada klaim akurasi yang menyapu semua lapisan sistem.
RQ3 adalah bagian yang paling kuat untuk mendukung tesis paper. Saat model dipertahankan tetap dan hanya lapisan enforcement yang diubah, pendekatan prompt-only membiarkan pelanggaran bahasa rekomendasi dan kebocoran trace internal mencapai pembaca pada 30 dari 30 run adversarial [1]. Harness memblokir seluruh pelanggaran tersebut [1]. Sebuah external guardrail tambahan juga mampu mencegah pelanggaran, tetapi efek sampingnya adalah over-refusal yang menurunkan utilitas menjadi 88/120, sementara harness mempertahankan utilitas penuh 120/120 [1]. Di titik ini, paper tidak hanya berbicara tentang keamanan, tetapi tentang trade-off keamanan dan kegunaan. Itu membuat argumennya lebih relevan untuk enterprise, karena sistem yang terlalu sering menolak juga dapat gagal secara produk.
Secara konseptual, paper ini sejalan dengan pandangan yang lebih luas bahwa performa agen berbasis foundation model lahir dari interaksi model, harness, dan lingkungan, bukan dari model saja [4]. Karena itu, keputusan untuk memindahkan kontrak yang bisa diverifikasi ke luar prompt terasa logis. Prompt dapat membantu mengarahkan perilaku, tetapi ia bukan tempat yang ideal untuk menyimpan jaminan yang harus lolos audit. Dengan menaruh kontrol pada artefak yang terversi, tervalidasi, dan dapat diuji ulang, paper ini mendekatkan pengembangan agen LLM ke disiplin rekayasa perangkat lunak yang lebih mapan [2][4].
Nilai praktis paper juga diperkuat oleh repositori referensi yang tersedia publik. Struktur repositori memperlihatkan adanya folder dan perintah kerja yang selaras dengan klaim paper mengenai versioned source, control, and validation artifacts, termasuk area untuk manifest mentah, evaluasi, prompt, pengujian, skrip, dan server [3]. Bagi peninjau teknis, keberadaan artefak semacam ini penting karena membuat kontribusi paper dapat diinspeksi sebagai pola engineering, bukan sekadar narasi konseptual. README repositori juga menegaskan pemisahan tanggung jawab: source eligibility, entity routing, claim admission, answer planning, dan trace generation dipisah ke kode/berkas, sementara LLM dipakai untuk language composition only [3].
Meski demikian, ada beberapa batasan yang perlu disampaikan dengan jujur. Pertama, ini masih preprint arXiv yang diajukan pada 9 Juli 2026, sehingga belum dapat diperlakukan sebagai konsensus akhir yang telah lolos penelaahan sejawat [1]. Kedua, paper secara eksplisit menyatakan bahwa evaluasinya berfokus pada system-level verifiability, bukan pada kualitas keputusan investasi [2]. Jadi, pembaca tidak boleh menafsirkan hasil ini sebagai bukti bahwa agen tersebut lebih unggul dalam memilih saham atau memberi nasihat finansial. Ketiga, validasi lebih banyak menguji preservasi kontrak dan resolusi referensi, bukan kebenaran hulu dari proses promosi klaim itu sendiri; ini adalah keterbatasan metodologis yang diakui penulis [2].
Jika diringkas dalam kerangka fakta, analisis, dan opini, maka posisinya dapat dibedakan sebagai berikut:
- Fakta: harness menjaga kontrak tertentu pada skenario validasi tetap, lolos pada 270 run untuk pemeriksaan yang dimiliki kode, dan mengungguli pendekatan prompt-only serta external guardrail dalam kombinasi keamanan dan utilitas pada ablation yang dilaporkan [1][2].
- Analisis: hasil ini menunjukkan bahwa auditability lebih kuat bila ditambatkan pada artefak sistem yang dapat divalidasi, bukan pada kepatuhan prompt semata [2][3][4].
- Opini: paper ini sangat menjanjikan sebagai pola rekayasa enterprise LLM, tetapi bukti saat ini masih paling kuat dibaca sebagai keberhasilan pada implementasi referensi yang terkurasi, belum sebagai validasi universal untuk semua domain enterprise [1][2].
Secara keseluruhan, saya menilai paper ini kuat sebagai artikel engineering dan cukup disiplin dalam membatasi klaimnya. Kontribusi terbaiknya bukan pada “membuat model lebih aman”, melainkan pada menunjukkan bahwa sebagian jaminan yang benar-benar dibutuhkan enterprise harus dimiliki oleh kode, skema, validator, dan trace yang bisa diaudit [1][2]. Dari sana, model menjadi komponen yang dapat diganti tanpa meruntuhkan kontrak sistem. Itulah ide yang paling berharga dari paper ini. Namun, karena domain uji masih sempit dan statusnya masih preprint, simpulan yang paling aman adalah bahwa paper ini menawarkan pola rekayasa yang sangat menjanjikan untuk mengubah prototipe LLM menjadi aplikasi yang lebih auditable, bukan bukti final bahwa semua agen enterprise kini dapat dijamin aman hanya dengan memasang harness [1][2][3].
Sumber Referensi
- From Prompts to Contracts: Harness Engineering for Auditable Enterprise LLM Agents
- From Prompts to Contracts: Harness Engineering for Auditable Enterprise LLM Agents
- GitHub - hammerbaki/enterprise-llm-agent-harness: Mobile briefing tool for Korea's five largest corporate groups (Samsung, SK, Hyundai Motor, LG, Hanwha) with source-linked claims and reproducible validation artifacts. · GitHub
- AI Harness Engineering: A Runtime Substrate for Foundation-Model Software Agents
- 전자공시 OPENDART 시스템 | 오픈API 소개 | 오픈API 소개