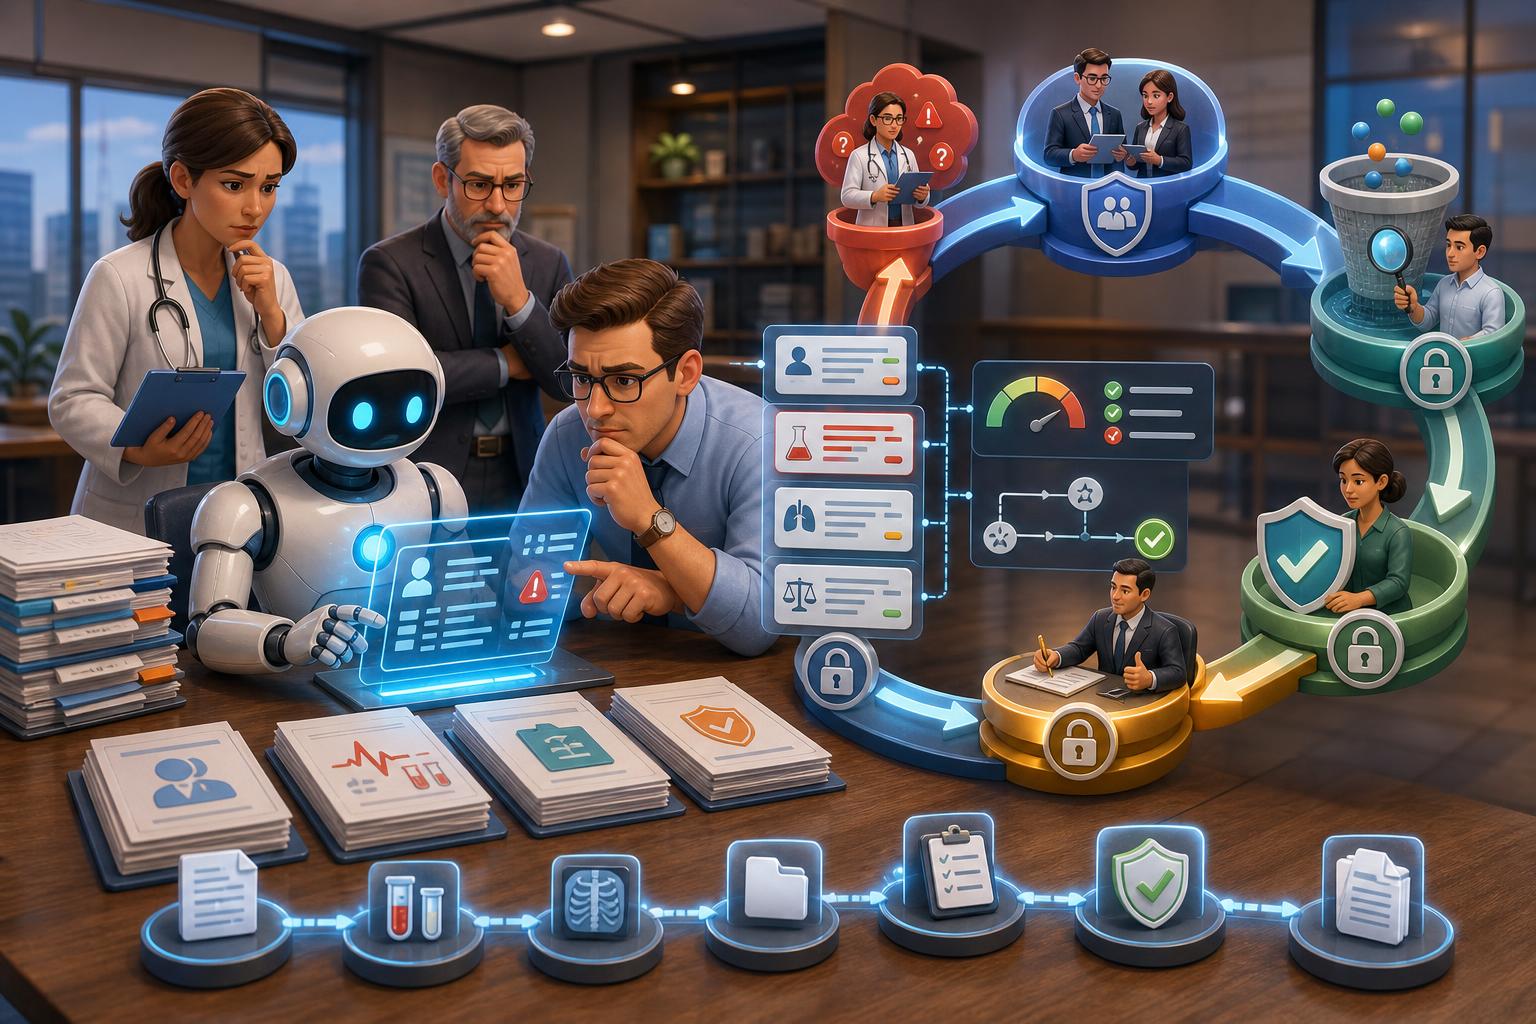
Agentic AI menawarkan lompatan kemampuan yang jauh melampaui otomatisasi administratif biasa. Dalam underwriting asuransi kesehatan, sistem semacam ini dapat membaca formulir aplikasi, deklarasi kesehatan, hasil pemeriksaan medis, hasil laboratorium, riwayat polis, riwayat klaim, informasi pekerjaan, data finansial yang relevan, ketentuan produk, panduan underwriting, hingga batasan reasuransi. Setelah itu, sistem dapat mengumpulkan data dari berbagai sumber, memeriksa kelengkapan, menandai anomali, menyusun alasan, dan akhirnya menghasilkan rekomendasi seperti penerimaan standar, penerimaan dengan ekstra premi, penundaan, rujukan ke penelaahan lanjutan, atau penolakan.
Namun semakin besar kemampuan agen AI untuk bertindak mandiri, semakin penting pula pertanyaan tentang pengendalian risiko. Fokus yang benar bukan sekadar membuat agen lebih pintar, melainkan membuatnya lebih andal tanpa menambah eksposur yang tidak perlu. Dalam konteks underwriting kesehatan yang menyangkut data sensitif, keputusan berisiko tinggi, dan kewajiban tata kelola, feedback loop tidak boleh dirancang sebagai mekanisme pembelajaran otomatis tanpa rem. Ia harus dirancang sebagai proses pembelajaran organisasi yang terkendali.
Prinsip pertama yang perlu ditegaskan adalah perbedaan antara continuous improvement dan uncontrolled continuous learning. Keduanya terdengar mirip, tetapi konsekuensinya sangat berbeda. Continuous improvement berarti sistem terus disempurnakan berdasarkan hasil penggunaan nyata. Sebaliknya, uncontrolled continuous learning berarti setiap koreksi manusia berpotensi langsung mengubah perilaku sistem berikutnya. Dalam underwriting asuransi kesehatan, pendekatan kedua terlalu berbahaya. Koreksi seorang underwriter belum tentu otomatis benar secara universal, belum tentu konsisten dengan kebijakan produk, dan belum tentu sesuai untuk seluruh segmen risiko.
Karena itu, arsitektur yang lebih aman adalah controlled learning. Agent bekerja di lingkungan produksi, manusia menelaah hasilnya, perbedaan keputusan dicatat, penyebabnya diklasifikasikan, pengetahuan baru divalidasi, perubahan diuji, dan hanya versi yang telah lolos pengendalian yang dilepas ke produksi. Dengan kata lain, feedback loop agentic AI seharusnya mengikuti disiplin siklus pengembangan sistem dan tata kelola model, bukan mekanisme pembelajaran spontan yang tidak memiliki pagar pembatas.
Dalam praktik underwriting, feedback loop dimulai dari setiap keputusan. Bayangkan sistem menerima satu aplikasi baru. Agen membaca formulir pengajuan, mendeteksi pernyataan kesehatan, menelusuri riwayat polis yang ada, memeriksa data klaim, menggabungkan hasil pemeriksaan medis, lalu menguji faktor-faktor seperti usia, indeks massa tubuh, status merokok, riwayat hipertensi, indikator diabetes, penggunaan obat, jenis pekerjaan, nilai pertanggungan, dan kebutuhan reasuransi. Berdasarkan rangkaian itu, agen menyimpulkan satu rekomendasi disertai alasan.
Misalkan agen merekomendasikan penerimaan standar, tetapi underwriter manusia memutuskan penerimaan dengan syarat tambahan. Nilai terbesar dari perbedaan ini bukan terletak pada fakta bahwa hasilnya berbeda, melainkan pada penjelasan mengapa perbedaan itu muncul. Apakah sistem gagal membaca dokumen? Apakah hasil laboratorium salah diekstraksi? Apakah terdapat informasi penting yang tidak berhasil ditemukan? Apakah istilah medis diinterpretasikan secara keliru? Apakah aturan underwriting tertentu tidak dijalankan? Apakah panduan yang dipakai sudah tidak mutakhir? Atau apakah kasus tersebut memang membutuhkan pertimbangan profesional yang belum dapat direduksi menjadi aturan formal?
Di sinilah konsep structured disagreement menjadi sangat penting. Sistem tidak cukup hanya merekam label benar atau salah. Sistem perlu menangkap jenis ketidaksepakatan secara terstruktur agar organisasi dapat mengetahui akar masalah. Kesalahan pembacaan dokumen memerlukan solusi yang berbeda dari kesalahan penalaran. Kesalahan pengambilan referensi memerlukan pendekatan yang berbeda dari aturan bisnis yang tidak lengkap. Kasus yang benar-benar bergantung pada penilaian profesional juga tidak semestinya diperlakukan sebagai kegagalan AI yang harus selalu diperbaiki menjadi keputusan otomatis. Dalam banyak situasi, hasil terbaik justru berupa peningkatan kemampuan sistem untuk mengenali batasnya sendiri dan melakukan eskalasi.
Salah satu jebakan paling umum adalah menganggap setiap underwriter override sebagai ground truth yang mutlak. Ini keliru. Underwriter adalah ahli, tetapi tetap manusia. Pada kasus yang berada di area abu-abu, dua underwriter berpengalaman dapat mengambil keputusan berbeda namun sama-sama dapat dipertanggungjawabkan. Karena itu, ketika keputusan AI tidak sama dengan keputusan manusia, organisasi tidak boleh langsung mengubah sistem agar selalu meniru hasil akhir tersebut. Feedback harus terlebih dahulu melalui mekanisme penelaahan.
Mekanisme penelaahan ini idealnya melibatkan fungsi yang sesuai dengan sifat kasus. Untuk kasus medis yang kompleks, masukan dari dokter penelaah atau penasihat medis dapat dibutuhkan. Untuk kasus dengan implikasi harga, koordinasi dengan aktuaria mungkin relevan. Untuk batas reasuransi, tim reasuransi perlu dilibatkan. Untuk konsistensi kebijakan, pemilik produk dan fungsi tata kelola harus memiliki ruang untuk menilai. Dari proses inilah perusahaan dapat membangun apa yang dapat disebut sebagai golden underwriting dataset, yaitu kumpulan kasus yang telah divalidasi, diberi keputusan akhir yang jelas, dan memiliki alasan yang terdokumentasi dengan baik.
Golden dataset sangat penting karena berfungsi sebagai tolok ukur regresi. Ketika prompt diperbarui, mesin ekstraksi dokumen diganti, basis pengetahuan disempurnakan, aturan bisnis diubah, model bahasa diperbarui, atau alur orkestrasi dimodifikasi, sistem baru harus diuji terhadap kumpulan kasus tersebut. Tujuannya bukan hanya mengejar peningkatan pada kasus yang sebelumnya bermasalah, tetapi juga memastikan bahwa kasus yang sebelumnya sudah benar tidak menjadi salah setelah perubahan dilakukan.
Pemahaman berikutnya yang krusial adalah bahwa feedback tidak selalu berarti pelatihan ulang model. Banyak organisasi terlalu cepat menyimpulkan bahwa setiap kelemahan agen hanya dapat diperbaiki dengan retraining. Padahal dalam underwriting kesehatan, perbaikan paling bermakna sering justru datang dari komponen lain. Bisa jadi masalah utamanya berada pada orkestrasi agen, kualitas ekstraksi dokumen, desain prompt, kamus terminologi medis, mekanisme pengambilan referensi, integrasi antarsistem, atau kalibrasi ambang keyakinan.
Misalnya ditemukan bahwa agen berulang kali gagal mempertimbangkan indikator tertentu karena nilainya tersembunyi di dalam berkas pemeriksaan yang panjang. Solusi yang lebih aman belum tentu melatih ulang model dasar. Solusi yang lebih kuat bisa berupa penataan ulang proses ekstraksi, normalisasi hasil laboratorium ke struktur yang konsisten, penambahan validasi deterministik, lalu menyajikan variabel yang telah diverifikasi itu kepada agen penalaran. Hasilnya biasanya lebih mudah dijelaskan, lebih stabil, dan lebih mudah diaudit.
Prinsip ini juga membuat keseluruhan sistem menjadi lebih dapat dipertanggungjawabkan. Jika suatu keputusan underwriting dipertanyakan, perusahaan perlu dapat menelusuri data apa yang dibaca agen, dari dokumen mana nilainya diambil, aturan versi mana yang aktif saat itu, referensi apa yang dipakai, alat apa yang dipanggil, dan bagaimana rekomendasi dihasilkan. Dalam lingkungan yang diatur ketat, kemampuan menelusuri asal-usul keputusan hampir sama pentingnya dengan akurasi keputusan itu sendiri.
Karena itu, alur perubahan yang aman sebaiknya menyerupai siklus pengembangan sistem modern. Produksi menghasilkan observasi. Observasi menghasilkan feedback terstruktur. Feedback terstruktur menghasilkan analisis penyebab. Analisis menghasilkan usulan perubahan. Usulan perubahan masuk ke pengembangan, pengujian, validasi domain, persetujuan tata kelola, penerapan terbatas, lalu kembali dimonitor di produksi. Ini adalah siklus belajar yang disiplin, bukan belajar liar.
Ambil ilustrasi sederhana. Dalam sekumpulan kasus, sebagian kecil menunjukkan ketidaksesuaian antara rekomendasi AI dan keputusan akhir yang telah divalidasi. Jika organisasi hanya melihat satu angka akurasi, informasi yang didapat sangat terbatas. Namun jika kasus-kasus tersebut dikelompokkan berdasarkan penyebab, hasilnya jauh lebih bernilai. Sebagian mungkin berasal dari data yang tidak lengkap, sebagian dari kegagalan membaca dokumen, sebagian dari aturan underwriting yang belum lengkap, sebagian dari konflik antar data medis, dan sebagian justru menunjukkan bahwa keputusan AI lebih konsisten dengan panduan dibanding keputusan awal manusia. Dengan klasifikasi seperti ini, organisasi mengetahui bagian mana dari sistem yang harus diperbaiki.
Setelah perubahan dirancang, penerapannya pun harus bertahap. Versi baru sebaiknya diuji pada kasus historis dan golden dataset. Setelah lolos, sistem dapat dijalankan dalam shadow mode, yakni memberi rekomendasi paralel tanpa memengaruhi keputusan operasional. Hasil versi lama, versi baru, dan keputusan manusia dibandingkan untuk mengamati pola. Jika perbaikannya konsisten dan tidak menimbulkan regresi pada area lain, barulah cakupan penerapan diperluas secara terkendali.
Dalam desain seperti ini, human in the loop bukan sekadar rencana cadangan ketika AI gagal. Keterlibatan manusia adalah bagian eksplisit dari arsitektur. Pada proses berisiko tinggi seperti underwriting kesehatan, manusia tetap memegang otoritas untuk verifikasi, koreksi, ratifikasi, atau penolakan terhadap rekomendasi agen. Bahkan pada tingkat kematangan yang tinggi sekalipun, tidak semua kasus layak diproses dengan tingkat otomasi yang sama.
Kasus yang lurus, datanya lengkap, risikonya rendah, dan aturannya sangat jelas memang dapat memperoleh tingkat otomasi yang lebih besar. Sebaliknya, gangguan kesehatan yang kompleks, bukti medis yang saling bertentangan, nilai pertanggungan yang besar, riwayat klaim yang tidak biasa, dugaan ketidakjujuran pengungkapan, ambang reasuransi, atau keyakinan sistem yang rendah seharusnya memicu eskalasi. Kemampuan agen untuk berkata, secara fungsional, “saya tidak cukup yakin untuk memutuskan kasus ini” adalah tanda kedewasaan desain, bukan kelemahan.
Aspek lain yang sering diremehkan adalah audit trail. Setiap keputusan sebaiknya menghasilkan jejak keputusan yang tidak mudah diubah. Jejak ini idealnya memuat dokumen yang dibaca, data yang diekstraksi, versi instruksi, versi aturan bisnis, sumber referensi yang digunakan, alat yang dipanggil, hasil tiap pemanggilan alat, indikator keyakinan, alasan utama rekomendasi, serta siapa yang memberi persetujuan akhir. Audit trail seperti ini membentuk feedback loop kedua: bukan dari koreksi manual semata, tetapi dari telemetri operasional yang terus-menerus.
Melalui telemetri, organisasi dapat mempelajari pola, bukan hanya insiden tunggal. Jika tingkat override meningkat setelah perubahan tertentu, mungkin terjadi regresi. Jika tingkat rujukan melonjak hanya pada produk tertentu, mungkin ada celah pengetahuan. Jika agen mulai sering gagal membaca laporan dari format rumah sakit tertentu, masalah mungkin berada pada ekstraksi dokumen. Jika satu kelompok kondisi medis tiba-tiba menerima rekomendasi yang jauh lebih ketat, maka perlu penelaahan terhadap konsistensi dan keadilan keputusan.
Monitoring setelah penerapan sama pentingnya dengan pengujian sebelum penerapan. Uji pra-produksi selalu berlangsung dalam lingkungan yang relatif terkendali, sementara dunia nyata menghadirkan variasi input, perubahan format dokumen, perilaku pengguna yang tidak terduga, dan interaksi antarsistem yang dinamis. Karena itu, kesehatan agentic underwriting system tidak boleh dipantau hanya melalui satu ukuran umum. Organisasi perlu melihat berbagai indikator operasional dan risiko secara bersama-sama.
- Tingkat kesesuaian antara rekomendasi agen dan keputusan akhir yang telah divalidasi.
- Tingkat override oleh underwriter dan pola override menurut jenis kasus.
- Tingkat referral atau eskalasi ke manusia.
- Akurasi ekstraksi dokumen dan kelengkapan data yang berhasil dihimpun.
- Keberhasilan eksekusi aturan bisnis dan konsistensi penerapannya.
- Tingkat alasan yang tidak didukung bukti atau penalaran yang lemah.
- Kegagalan alat, keterlambatan pemrosesan, dan kualitas integrasi.
- Tingkat straight-through processing pada kasus yang memang layak diotomasi.
Yang tidak kalah penting, metrik tersebut sebaiknya dilihat menurut segmen risiko, bukan hanya dalam agregat. Kinerja keseluruhan yang tampak baik dapat menyembunyikan masalah pada kelompok kasus tertentu. Oleh sebab itu, analisis sebaiknya memerhatikan variasi menurut tipe produk, kelompok usia yang relevan, karakteristik impairment medis, kelas pekerjaan, nilai pertanggungan, jalur akuisisi, dan sumber dokumen, sejauh analisis itu sah secara hukum dan etis.
Feedback jangka panjang juga dapat datang dari pengalaman setelah polis diterbitkan. Dalam industri asuransi, keputusan underwriting pada akhirnya akan berinteraksi dengan pengalaman klaim, persistensi polis, indikasi kecurangan, dan hasil reasuransi. Informasi ini berharga untuk menilai apakah kebijakan underwriting dan strategi seleksi risiko masih tepat. Namun hubungan sebab akibatnya tidak pernah sederhana. Tidak adanya klaim tidak otomatis membuktikan bahwa keputusan underwriting sebelumnya benar, dan terjadinya klaim juga tidak otomatis membuktikan bahwa underwriting salah.
Karena itu, data jangka panjang lebih tepat digunakan sebagai bahan analisis aktuarial, evaluasi kebijakan underwriting, dan peninjauan portofolio daripada langsung dijadikan sinyal pelatihan otomatis bagi agen. Jika dipakai secara serampangan, organisasi dapat menarik kesimpulan yang keliru akibat bias seleksi, jeda waktu yang panjang, karakteristik produk, atau perubahan perilaku pemegang polis. Feedback jangka panjang harus dibaca sebagai bahan pembelajaran strategis, bukan umpan balik instan.
Paradoks penting lain adalah bahwa semakin banyak feedback belum tentu semakin baik. Feedback yang bising, bias, atau salah dapat menurunkan mutu sistem. Seorang underwriter senior mungkin memiliki intuisi sangat tajam, tetapi sebagian intuisi itu bisa merupakan pengalaman kontekstual yang tidak selalu tepat diubah menjadi aturan universal. Jika setiap override senior langsung diadopsi menjadi perilaku sistem, organisasi berisiko mentransformasikan preferensi individual menjadi bias kelembagaan.
Oleh karena itu, knowledge capture harus dibedakan dari rule adoption. Ketika ahli memberikan koreksi, organisasi perlu bertanya: apakah ini prinsip underwriting yang benar-benar berlaku umum, atau hanya penilaian situasional? Apakah dapat dijelaskan secara konsisten? Apakah sejalan dengan kebijakan produk, toleransi risiko, dan praktik persetujuan yang sah? Apakah berlaku untuk semua kasus serupa atau hanya subset tertentu? Baru setelah pertanyaan-pertanyaan ini dijawab, pengetahuan individual layak berubah menjadi pengetahuan institusional.
Pembahasan tentang keamanan feedback loop juga tidak dapat dilepaskan dari sensitivitas data kesehatan. Dataset underwriting memuat informasi yang sangat pribadi. Karena itu, data yang digunakan untuk evaluasi, kalibrasi, atau peningkatan sistem tidak boleh diperlakukan seperti data aplikasi biasa. Organisasi memerlukan kontrol akses yang ketat, kebijakan retensi yang jelas, pencatatan akses, pemisahan tugas, serta teknik penyamaran atau pseudonimisasi bila sesuai dan dimungkinkan. Tidak semua orang yang terlibat dalam pengembangan sistem harus dapat melihat detail medis mentah.
Selain pengamanan data, perlu pula ada pengamanan keputusan. Dalam praktik yang matang, perubahan pada prompt, aturan, kamus medis, ambang keyakinan, atau integrasi alat tidak dilakukan diam-diam. Setiap perubahan idealnya memiliki tiket perubahan, penanggung jawab, alasan bisnis, hasil pengujian, dampak yang diharapkan, dan rencana pemantauan setelah rilis. Dengan pendekatan ini, peningkatan kualitas sistem menjadi proses yang dapat diaudit dan dapat dipertanggungjawabkan.
Secara arsitektural, feedback loop yang aman dapat dibayangkan sebagai beberapa lapisan. Lapisan pertama adalah lapisan operasional, tempat agen bekerja pada kasus nyata. Lapisan kedua adalah lapisan observasi, tempat keputusan, override, referral, dan sinyal kegagalan dikumpulkan. Lapisan ketiga adalah lapisan adjudikasi, tempat ahli memutuskan apakah perbedaan keputusan mencerminkan kesalahan sistem, kekurangan data, kebutuhan aturan baru, atau kasus yang memang harus tetap berada di tangan manusia. Lapisan keempat adalah lapisan perubahan terkontrol, tempat pembaruan dirancang, diuji, dan disetujui. Lapisan kelima adalah lapisan monitoring, tempat dampak pembaruan diamati secara berkelanjutan.
Bila dirumuskan secara singkat, siklus yang sehat adalah sebagai berikut: agen bertindak, manusia mengamati, pengecualian ditangkap, pengetahuan divalidasi, perubahan diuji, tata kelola menyetujui, sistem diperbarui secara terkendali, lalu produksi dimonitor untuk menghasilkan feedback berikutnya. Perbedaan antara pendekatan ini dengan pembelajaran otomatis tanpa pengawasan tampak kecil di atas kertas, tetapi sangat besar dampaknya dalam praktik. Yang diperkuat bukan hanya kecerdasan sistem, melainkan juga disiplin kelembagaan di sekelilingnya.
Pada akhirnya, tujuan feedback loop yang aman bukan menciptakan agen yang setiap hari makin bebas mengambil keputusan sendiri. Tujuannya adalah menciptakan sistem yang setiap hari makin memahami apa yang dapat diotomasi, apa yang harus diverifikasi, apa yang harus dieskalasikan, dan kapan penilaian manusia tetap harus menjadi otoritas terakhir. Dalam underwriting asuransi kesehatan, kepercayaan, keterjelasan alasan, dan akuntabilitas jauh lebih berharga daripada kecepatan yang tidak terkendali.
Agentic AI yang matang bukanlah agen yang menghapus peran underwriter, melainkan sistem yang mampu mengubah pengalaman manusia menjadi kecerdasan organisasi tanpa melepaskan tata kelola. Sistem seperti itu tidak belajar secara liar dari setiap koreksi, tetapi belajar secara disiplin dari pola-pola yang telah divalidasi. Ia tidak berlomba menjadi paling otonom, melainkan paling dapat dipercaya. Dan justru dalam industri yang menuntut kehati-hatian tinggi, itulah bentuk kemajuan yang paling bernilai.