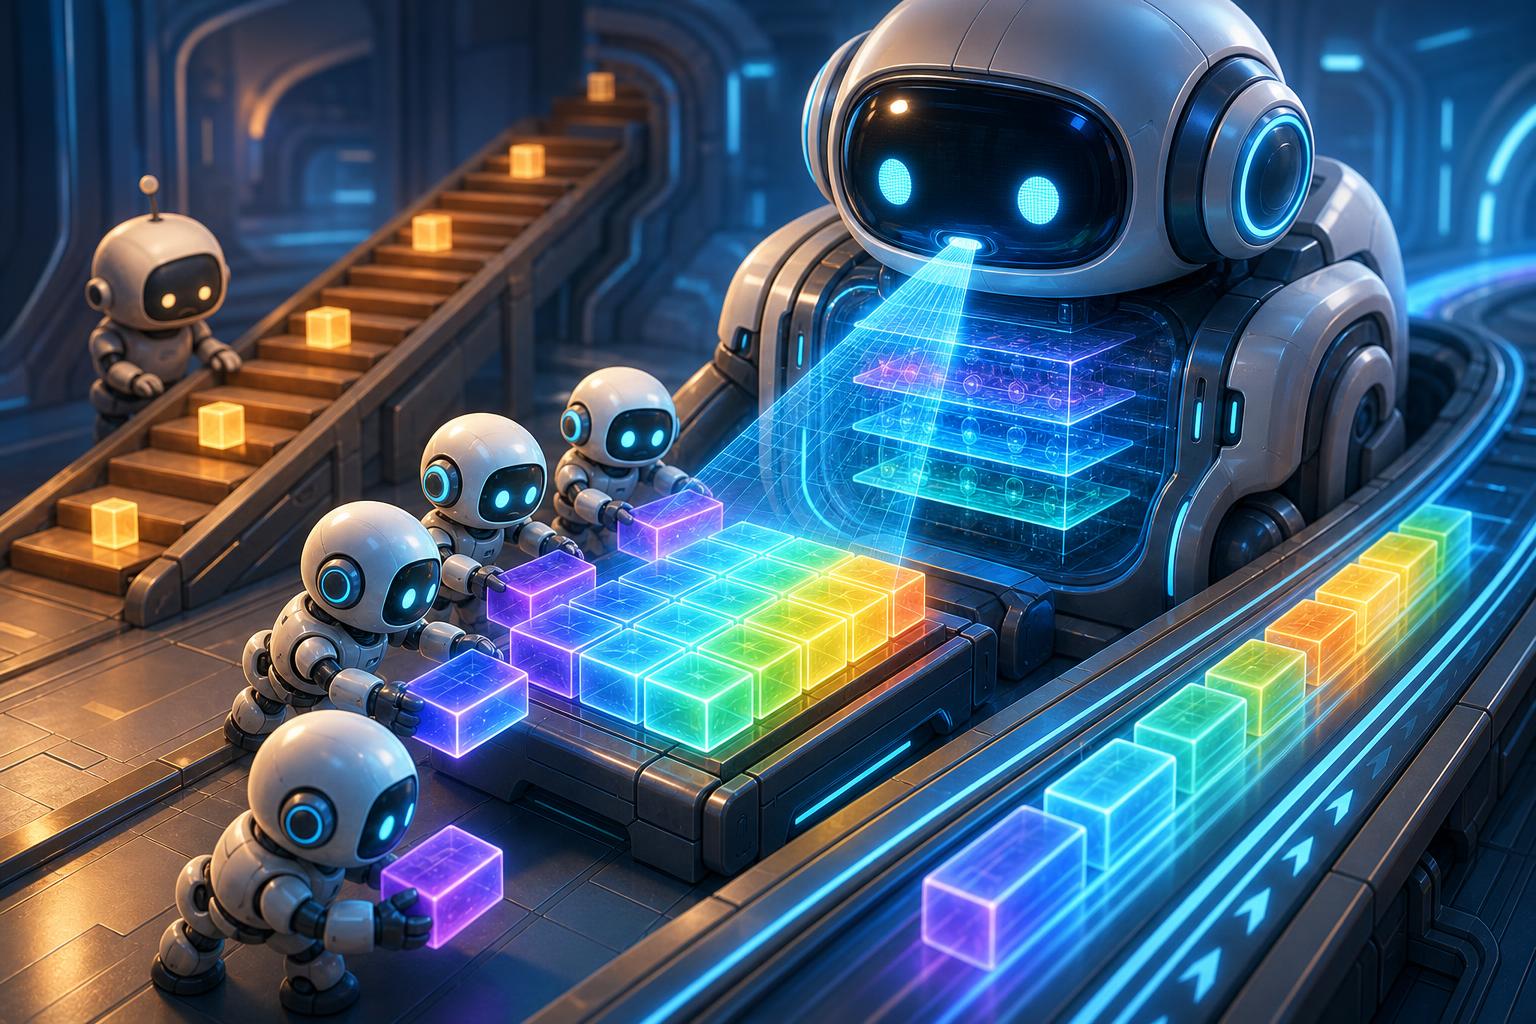
Selama ini, banyak orang membayangkan kecerdasan buatan bekerja seperti penulis yang mengetik kalimat dengan lancar. Kenyataannya, pada sebagian besar large language model, proses menghasilkan jawaban jauh lebih mekanis: model memprediksi satu token, lalu memakai token itu untuk memprediksi token berikutnya, dan seterusnya. Cara ini sangat efektif untuk membangun bahasa secara runtut, tetapi juga menyimpan keterbatasan mendasar. Semakin panjang jawaban, semakin panjang pula antrean langkah yang harus dijalankan.
Di sinilah DFlash 2 menjadi menarik. Gagasan utamanya bukan sekadar membuat model lebih kecil atau memaksa model berpikir lebih singkat, melainkan mengubah cara token diproduksi saat inference. Jika selama ini model besar cenderung berjalan seperti orang yang melangkah satu anak tangga setiap kali, DFlash 2 mencoba membuat sistem dapat menyiapkan beberapa pijakan sekaligus, lalu memeriksa mana yang benar untuk dilanjutkan.
Artikel ini membahas masalah yang ingin dipecahkan, solusi yang ditawarkan, analogi agar konsepnya lebih mudah dipahami, serta implikasinya bagi sistem AI modern. Fokusnya bukan pada klaim angka tertentu, melainkan pada logika teknis di balik perubahan pendekatan tersebut.
Pertama, kita perlu memahami akar persoalannya. Sebagian besar language model modern memakai pola autoregressive decoding. Artinya, token berikutnya selalu bergantung pada token sebelumnya. Jika model ingin menulis kalimat panjang, ia tidak menyusun seluruh kalimat dalam satu langkah. Ia membuat potongan kecil demi potongan kecil secara berurutan. Dari sudut pandang teori probabilitas, pendekatan ini masuk akal, karena urutan bahasa memang dapat dipecah menjadi rangkaian prediksi bersyarat. Namun dari sudut pandang sistem komputasi, pola tersebut melahirkan hambatan yang sangat jelas: serialitas.
Serialitas berarti pekerjaan tidak mudah dibagi menjadi banyak bagian yang bisa dikerjakan bersamaan. Padahal perangkat keras modern, terutama GPU, dirancang untuk mengeksekusi banyak operasi paralel. Ketika model harus menunggu hasil token sebelumnya sebelum dapat memikirkan token berikutnya, sebagian kemampuan paralel itu tidak termanfaatkan secara ideal. Ibarat memiliki pabrik besar dengan banyak jalur produksi, tetapi bahan baku hanya datang satu per satu. Mesin tetap canggih, tetapi aliran kerja tidak cukup lebar untuk memanfaatkannya sepenuhnya.
Masalah ini makin terasa pada model reasoning dan agentic AI. Sistem seperti ini sering kali tidak hanya menjawab singkat, melainkan melakukan langkah berpikir berantai, menyusun kode, membaca hasil eksekusi, lalu mencoba lagi. Dalam pola kerja seperti itu, jumlah token yang keluar bisa sangat panjang. Jika setiap token masih harus dihasilkan satu demi satu, maka keterlambatan kecil pada level token akan menumpuk menjadi waktu tunggu yang signifikan pada level tugas.
Karena itu, persoalannya bukan lagi semata-mata apakah model cukup pintar, melainkan apakah model dapat dieksekusi dengan efisien. Kecerdasan yang tinggi tetapi lambat dan mahal bisa menjadi hambatan nyata dalam penggunaan dunia nyata, terutama ketika sistem harus melayani banyak permintaan sekaligus atau menjalankan agen yang aktif dalam durasi panjang.
Salah satu jawaban awal terhadap masalah ini adalah speculative decoding. Konsep dasarnya cukup elegan. Daripada meminta model besar menghasilkan setiap token sendirian, kita menghadirkan model pendamping yang lebih ringan sebagai drafter. Model kecil ini menebak beberapa token ke depan. Setelah itu, model target yang lebih besar memeriksa tebakan tersebut. Jika tebakan awal sesuai, beberapa token dapat diterima sekaligus. Dengan demikian, satu siklus verifikasi oleh model besar berpotensi menghasilkan lebih dari satu token output.
Analogi sederhananya seperti ini. Bayangkan seorang editor senior sangat teliti, tetapi lambat jika harus menulis sendiri dari nol. Lalu hadir asisten yang lebih cepat. Asisten menyiapkan draf beberapa kata atau kalimat, kemudian editor senior cukup memeriksa. Jika draf asisten cukup akurat, editor tidak perlu menulis ulang semuanya. Produktivitas meningkat karena tokoh yang paling mahal, yaitu editor senior, tidak dipakai untuk setiap langkah kecil.
Namun speculative decoding generasi awal masih menyisakan ironi. Memang benar model target kini dapat memverifikasi beberapa token sekaligus, tetapi model drafter sendiri sering tetap bekerja secara autoregresif. Jadi, untuk menyiapkan banyak token tebakan, model kecil masih harus menyusunnya satu per satu. Kita mengurangi hambatan di satu titik, tetapi belum benar-benar menghilangkan sifat serial dari keseluruhan proses.
DFlash muncul sebagai upaya menyerang titik lemah itu. Alih-alih meminta drafter menebak token secara berurutan, pendekatan ini mengarah pada drafting paralel dalam bentuk blok. Secara intuitif, sistem tidak lagi berkata, “tebak kata pertama dulu, baru kata kedua, lalu ketiga.” Sebaliknya, sistem menyiapkan beberapa posisi kosong sekaligus, lalu mengisi semuanya dalam satu langkah prediksi paralel. Ini menggeser masalah dari urutan sempit ke beban kerja yang lebih cocok bagi GPU.
Jika pada pendekatan lama kita seperti menyusun puzzle keping demi keping dalam garis lurus, pada pendekatan baru kita seperti menaruh beberapa keping sekaligus berdasarkan pola besar yang sudah terlihat. Hasilnya belum tentu langsung sempurna, tetapi cukup baik untuk diverifikasi oleh model target. Selama cukup banyak bagian yang cocok, throughput sistem meningkat.
Bagian penting berikutnya adalah penerimaan atau acceptance. Draft paralel hanya berguna jika cukup banyak token yang disetujui model target. Bila drafter menghasilkan blok panjang tetapi model target hanya menerima satu token pertama, maka keuntungan mengecil. Karena itu, kualitas tebakan tetap menentukan nilai praktis dari pendekatan ini. DFlash 2 relevan justru karena mencoba menjaga dua hal sekaligus: drafting tetap paralel, tetapi token yang diterima per siklus juga ditingkatkan.
Dalam bahasa yang lebih sederhana, DFlash 2 tidak ingin kembali ke cara lama yang lambat hanya demi menebak lebih akurat. Tujuannya adalah mempertahankan kecepatan paralel, sambil memperbesar bagian tebakan yang benar-benar bisa dipakai. Ini penting, karena dalam inference modern, efisiensi bukan hanya soal seberapa cepat satu komponen bekerja, tetapi seberapa banyak hasil berguna yang keluar dari setiap putaran komputasi.
Analogi lain dapat membantu. Bayangkan sebuah tim arsitek. Cara lama adalah kepala arsitek menggambar garis demi garis. Cara speculative decoding biasa adalah asisten menggambar bagian kasar satu garis demi satu garis, lalu kepala arsitek mengoreksi. Cara DFlash lebih dekat dengan: asisten langsung menyusun satu sketsa blok ruangan sekaligus, kemudian kepala arsitek memeriksa struktur besarnya. DFlash 2 berusaha membuat sketsa blok itu tidak hanya cepat, tetapi juga lebih sering benar di bagian yang penting.
Ada alasan mengapa pendekatan seperti ini masuk akal. Model target sebenarnya sudah memahami konteks dengan sangat kaya melalui representasi internalnya. Dalam transformer, informasi tidak hanya hidup pada token output terakhir, tetapi tersebar dalam hidden states di banyak lapisan. Jika representasi internal ini dapat dimanfaatkan untuk membantu drafter, maka drafter tidak perlu memulai dari nol. Ia tidak lagi seperti penebak liar, melainkan seperti asisten yang mendapat petunjuk langsung dari orang yang paling paham isi dokumen.
Itulah salah satu gagasan penting di balik keluarga pendekatan seperti DFlash: hidden representation diperlakukan sebagai aset komputasi. Selama ini orang cenderung melihat keluaran utama model sebagai token akhir. Padahal di dalam jaringan terdapat jejak pemahaman konteks yang kaya. Jika jejak ini dipakai untuk mengondisikan drafter, maka blok token yang diusulkan bisa menjadi lebih selaras dengan apa yang kemungkinan besar akan dipilih oleh model target.
Dari sini, kita bisa melihat mengapa DFlash 2 bukan sekadar trik percepatan kecil. Ia menyentuh cara berpikir baru tentang inference. Fokusnya bergeser dari “berapa besar model utama” ke “bagaimana pekerjaan model utama didistribusikan.” Dalam sistem AI modern, model besar tidak harus mengerjakan semua langkah kecil sendirian. Ia bisa menjadi sumber otoritas yang memverifikasi dan mengarahkan, sementara modul ringan menangani proposal awal yang cepat.
Ini sangat relevan untuk aplikasi coding. Kode sering memiliki pola yang lebih terstruktur daripada prosa kreatif. Setelah beberapa token awal muncul, kelanjutan yang masuk akal sering lebih sempit. Struktur kurung, blok, penamaan fungsi, hingga pola sintaks membuat prediksi lokal lebih mudah ditebak. Dalam situasi seperti ini, speculative drafting cenderung lebih menguntungkan karena peluang token diterima lebih tinggi. Sebaliknya, pada teks yang sangat bebas dan bercabang, tebakan blok dapat lebih sering meleset.
Artinya, manfaat DFlash 2 bersifat kontekstual. Ia bukan tongkat ajaib yang pasti unggul dalam semua tugas. Pada keluaran yang sangat terstruktur, keuntungannya cenderung lebih terasa. Pada konteks panjang dan keluaran yang lebih kreatif atau sangat tidak terduga, keuntungan bisa mengecil. Karena itu evaluasi sistem sebaiknya memakai beban kerja nyata, bukan hanya contoh singkat yang mudah dipercepat.
Kita juga perlu menempatkan DFlash 2 di antara pendekatan lain. Ada metode yang menambahkan kemampuan multi-token prediction secara native pada model, ada pula teknik speculative decoding lain dengan drafter yang masih autoregresif. Perbedaannya bukan sekadar nama, melainkan filosofi desain. Pendekatan dengan multi-token prediction menanamkan kemampuan menebak beberapa langkah ke depan ke dalam model itu sendiri. Pendekatan seperti DFlash memakai modul drafter terpisah yang ringan, lalu mengandalkan verifikasi oleh target. Keduanya sama-sama berusaha mengurangi biaya per token berguna, tetapi jalur implementasinya berbeda.
Di tingkat infrastruktur, perubahan ini sangat penting. Dulu optimasi inference sering dipahami sebagai urusan kuantisasi, batching, cache, dan kernel. Kini ada lapisan tambahan: algoritma decoding itu sendiri. Dengan kata lain, dua deployment yang memakai model dasar yang sama dapat memiliki pengalaman pengguna yang sangat berbeda hanya karena strategi eksekusinya berbeda. Model identik tidak selalu berarti layanan identik.
Hal ini mengubah cara organisasi menilai sistem AI. Yang dievaluasi bukan lagi model semata, melainkan paket lengkap: model target, metode drafting, runtime, pengelolaan memori, dan kecocokan dengan perangkat keras. Suatu model yang tampak sedikit lebih lambat di atas kertas bisa menjadi lebih menarik jika memiliki dukungan execution stack yang lebih matang dan efisien.
Meski menjanjikan, ada beberapa batasan yang perlu dipahami secara jernih. Pertama, pendekatan semacam ini menambah kompleksitas arsitektur. Kita tidak lagi hanya memuat satu model, tetapi juga modul drafter dan mekanisme verifikasi. Kedua, ada biaya memori tambahan. Ketiga, kecocokan antara drafter dan target bukan perkara sepele. Tidak semua pasangan model akan bekerja optimal. Keempat, hasil sangat tergantung pada karakter prompt, panjang konteks, dan pola keluaran.
Karena itu, ukuran keberhasilan tidak boleh disederhanakan menjadi tokens per second saja. Dalam sistem produksi, metrik yang penting meliputi waktu menuju token pertama, waktu per token keluaran, stabilitas di bawah concurrency, penggunaan memori, serta waktu penyelesaian tugas dari awal sampai akhir. Sebuah metode bisa terlihat impresif pada satu skenario pengguna tunggal, tetapi tidak efisien saat banyak permintaan datang bersamaan. Sebaliknya, ada pula metode yang tampak biasa pada benchmark kecil namun unggul dalam lalu lintas nyata.
Dari perspektif ekonomi, makna DFlash 2 cukup besar. Jika sistem dapat menghasilkan lebih banyak token berguna per siklus komputasi, maka biaya efektif per hasil menurun. Penyedia layanan bisa memakai keuntungan ini untuk mempercepat respons, menekan biaya operasional, memperpanjang kemampuan reasoning, atau melayani lebih banyak agen pada sumber daya yang sama. Bagi pengguna akhir, dampaknya bisa terasa sebagai layanan yang lebih responsif tanpa harus mengubah kecerdasan inti model.
Ini juga mengubah diskusi tentang masa depan AI. Selama beberapa tahun, perhatian banyak tersedot pada pertanyaan tentang seberapa besar model dan seberapa kuat kemampuan reasoning-nya. Kini semakin jelas bahwa kecerdasan dan eksekusi adalah dua disiplin yang saling terkait tetapi berbeda. Satu pihak berbicara tentang pelatihan, alignment, dan kualitas jawaban. Pihak lain berbicara tentang bagaimana jawaban itu dihasilkan dengan cepat, hemat, dan stabil di atas perangkat keras nyata.
DFlash 2 menarik karena berada tepat di pertemuan dua dunia itu. Ia tidak menuntut kita mengorbankan model target demi kecepatan, tetapi juga tidak menerima begitu saja bahwa inference harus selalu berjalan satu token per langkah. Ia menyampaikan pesan yang lebih luas: sistem AI dapat dirancang ulang agar pekerjaan berat dibagi secara lebih cerdas antara model utama dan modul pendukung.
Dalam jangka panjang, arah ini bisa berkembang menjadi inference yang adaptif. Sistem dapat memilih strategi decoding berdasarkan jenis tugas. Untuk keluaran yang terstruktur, sistem dapat bersikap agresif dalam speculation. Untuk keluaran yang lebih liar, sistem dapat menjadi konservatif. Bahkan mungkin suatu saat runtime AI bertindak seperti compiler yang secara otomatis memilih jalur eksekusi paling efisien berdasarkan konteks, panjang prompt, dan profil perangkat keras.
Bila itu terjadi, maka pertanyaan penting saat memilih teknologi AI tidak lagi berhenti pada “model mana yang paling cerdas,” tetapi meluas menjadi “kombinasi model, metode decoding, runtime, dan hardware mana yang paling efisien untuk pekerjaan ini.” DFlash 2 layak diperhatikan karena ia membantu mendorong perubahan cara pandang tersebut.
Kesimpulannya, DFlash 2 penting bukan hanya karena menjanjikan percepatan, melainkan karena menunjukkan perubahan paradigma. Autoregressive decoding telah lama menjadi fondasi language model, tetapi ia juga membawa bottleneck yang makin mahal ketika model dipakai untuk reasoning panjang dan agentic workflow. Speculative decoding mencoba mengurangi beban itu dengan memisahkan penebakan cepat dari verifikasi akurat. DFlash lalu mendorong ide itu lebih jauh dengan drafting paralel, dan DFlash 2 menekankan bahwa drafting paralel harus tetap dipertahankan sambil meningkatkan hasil yang benar-benar diterima.
Dengan kata lain, ini bukan sekadar cerita tentang AI yang “menebak lebih cepat.” Ini adalah cerita tentang bagaimana inference berubah dari proses linear menjadi masalah penjadwalan, verifikasi, dan pemanfaatan sumber daya. Ketika AI tidak lagi harus menebak token satu per satu, yang berubah bukan cuma kecepatannya, tetapi juga cara kita mendesain seluruh mesin di belakangnya.
Untuk pembaca yang ingin memperdalam konsep dasar yang relevan dengan topik ini, berikut beberapa sumber bacaan umum yang valid dan berguna. Tautan-tautan ini dipilih sebagai rujukan konsep, bukan sebagai dasar klaim angka spesifik dalam artikel ini.
- https://arxiv.org/abs/1706.03762 — paper dasar tentang arsitektur Transformer.
- https://huggingface.co/docs/transformers/main/en/generation_strategies — pengantar strategi generasi teks pada model bahasa.
- https://huggingface.co/docs/text-generation-inference/main/en/index — dokumentasi umum inference untuk language model.
- https://docs.vllm.ai/ — dokumentasi engine inference LLM yang relevan untuk memahami serving dan decoding.
- https://docs.sglang.ai/ — dokumentasi runtime inference yang sering membahas optimasi decoding.
- https://developer.nvidia.com/blog/ — blog teknis umum tentang optimasi inference dan pemanfaatan GPU.
- https://research.google/pubs/pub46201/ — laman publikasi resmi untuk makalah Transformer.
Jika diringkas dalam satu kalimat, DFlash 2 menunjukkan bahwa masa depan AI tidak hanya ditentukan oleh seberapa baik model berpikir, tetapi juga oleh seberapa cerdas kita mengatur cara model itu mengeksekusi pikirannya.