Kalau selama ini banyak orang menganggap AI visual itu tugasnya cuma “lihat gambar lalu kasih label”, NVIDIA sedang mendorong arah yang jauh lebih menarik. Lewat rilis Cosmos 3 Edge pada 20 Juli 2026, NVIDIA memperkenalkan model AI yang bukan cuma bisa mengenali apa yang ada di depan kamera, tetapi juga mencoba memahami bagaimana dunia fisik berubah dari waktu ke waktu, apa konsekuensi dari sebuah aksi, dan langkah apa yang paling masuk akal berikutnya.[1][2]
Ini penting karena di dunia robotika dan Vision AI, masalah utamanya memang bukan sekadar identifikasi objek. Tantangan sebenarnya adalah memahami dinamika. Kamera pintar, robot gudang, kendaraan otonom, sampai sistem industri tidak hidup di dunia yang statis. Mereka bekerja di lingkungan yang terus bergerak, berubah, dan penuh interaksi sebab-akibat. Di situlah Cosmos 3 Edge diposisikan: sebagai world foundation model 4 miliar parameter yang dirancang untuk berjalan di perangkat edge dan tersedia secara terbuka melalui Hugging Face agar bisa dipakai, dipelajari, dan dikembangkan lebih lanjut oleh komunitas.[1][2][3]
Satu hal yang perlu dijaga sejak awal: istilah yang paling aman untuk model ini adalah open model atau model yang tersedia publik, bukan disederhanakan menjadi “open-source penuh” dalam arti umum. Bobot model tersedia dengan lisensi OpenMDW-1.1, dan ekosistem framework serta repositorinya juga dibuka lewat GitHub.[2][4] Buat developer, ini tetap kabar besar, karena akses terbuka seperti ini mempercepat eksperimen, evaluasi, dan adaptasi model untuk kasus penggunaan nyata.
Secara sederhana, Cosmos 3 Edge ingin menjawab kebutuhan baru di ranah physical AI: bagaimana membuat sistem cerdas yang bisa mengamati dunia, menalar apa yang sedang terjadi, memperkirakan apa yang mungkin terjadi berikutnya, lalu menentukan aksi yang relevan—semuanya dengan efisien di perangkat lokal.[1][3]
Kenapa ini menarik? Karena selama bertahun-tahun, banyak model visual memang jago membaca isi frame, tapi belum tentu paham “alur kejadian” di balik frame tersebut. Misalnya, model tahu ada pisang di meja. Oke, bagus. Tapi untuk robot, pengetahuan itu belum cukup. Robot juga perlu tahu posisi pisang terhadap lengannya, arah gerak gripper, apa yang mungkin terjadi saat kontak terjadi, apakah pisang akan bergeser, dan tindakan apa yang peluang berhasilnya paling tinggi.[1] Di sinilah konsep world model menjadi relevan.
World model pada dasarnya adalah pendekatan AI yang mempelajari bagaimana lingkungan berubah dari waktu ke waktu. Bukan hanya objek, tetapi juga gerakan, relasi spasial, hubungan sebab-akibat, sampai konsekuensi dari sebuah tindakan.[1] Jadi kalau VLM tradisional sering berhenti di tahap “apa yang terlihat”, world model melangkah ke level “apa yang sedang terjadi, kenapa itu terjadi, dan apa yang mungkin terjadi setelah ini”.
Dalam bahasa yang lebih santai: model seperti ini tidak cuma punya “mata”, tapi mulai dibekali semacam “intuisi fisik”. Tentu intuisi itu masih berbentuk representasi statistik, bukan pemahaman manusia sepenuhnya. Namun untuk aplikasi robotika, lompatan ini sangat berarti. Soalnya keputusan di dunia nyata sering kali harus dibuat dalam hitungan cepat dan berdasarkan prediksi perubahan lingkungan.
Aspek lain yang bikin Cosmos 3 Edge menonjol adalah desainnya untuk komputasi edge. Banyak model AI besar butuh GPU kelas pusat data dan memori yang besar agar bisa berjalan lancar. Cosmos 3 Edge justru dioptimalkan agar efisien untuk deployment lokal di perangkat dengan sumber daya lebih terbatas, termasuk lini NVIDIA Jetson, RTX PRO, sistem DGX, dan GeForce RTX GPU.[1][3] Dengan begitu, sistem seperti robot, kamera pintar, atau mesin industri tidak harus selalu bergantung pada cloud setiap kali ingin mengambil keputusan.
Keuntungan pendekatan edge jelas besar. Pertama, latensi bisa lebih rendah karena inferensi dilakukan lebih dekat ke sumber data. Kedua, sistem lebih andal di lingkungan yang konektivitasnya tidak selalu stabil. Ketiga, dalam banyak skenario industri atau infrastruktur kritikal, memproses data secara lokal juga lebih nyaman dari sisi operasional. Jadi, walaupun ukuran modelnya “hanya” 4B parameter, nilai utamanya justru ada di efisiensi dan relevansi desainnya untuk penggunaan nyata.[1][3]
Menariknya lagi, NVIDIA tidak membingkai Cosmos 3 Edge sekadar sebagai VLM. Ya, model ini memang bisa dipakai untuk memahami gambar, video, instruksi bahasa alami, dan hubungan antarelemen visual.[1][3] Tetapi diferensiasi utamanya datang dari peran sebagai World Action Model atau WAM. Di mode ini, model tidak berhenti di pemahaman multimodal, melainkan ikut memperkirakan perubahan dunia, menghasilkan aksi, dan memprediksi hasil dari aksi tersebut.[1]
Kalau dibayangkan dalam praktik, ini seperti memberi AI kemampuan untuk menjawab pertanyaan semacam: “Kalau robot melakukan gerakan ini, apa yang kemungkinan akan terlihat beberapa saat setelahnya?” atau “Dari kondisi lingkungan saat ini, tindakan mana yang paling tepat untuk mencapai target?” Buat robotika, ini jauh lebih penting daripada sekadar captioning gambar.
Dari sisi arsitektur, Cosmos 3 menggunakan pendekatan yang oleh NVIDIA dijelaskan sebagai Mixture-of-Transformers dengan dua tower transformer yang saling melengkapi.[1] Ini salah satu bagian paling menarik karena menjelaskan kenapa model ini bisa menggabungkan reasoning dan generasi aksi/dunia dalam satu sistem.
- Transformer pertama adalah autoregressive transformer. Tugasnya fokus pada understanding dan reasoning berbasis token diskret, termasuk memahami gambar dan bahasa, lalu menghasilkan token penalaran dengan pola pemrosesan berurutan yang mirip keluarga model GPT.[1]
- Transformer kedua adalah diffusion transformer. Komponen ini menangani generasi multimodal kontinu seperti video, audio, dan action. Dengan kata lain, bagian ini lebih dekat ke simulasi dunia, prediksi masa depan, dan keluaran aksi yang bersifat dinamis.[1]
Yang bikin arsitektur ini tidak terasa seperti dua model yang bekerja sendiri-sendiri adalah adanya shared multimodal attention. Menurut penjelasan resmi NVIDIA, kedua tower berbagi lapisan atensi multimodal sehingga representasi bahasa, video, audio, dan aksi bisa disejajarkan sebelum output akhir dihasilkan.[1] Implikasinya besar: model bisa melakukan reasoning dulu, baru menghasilkan tindakan atau simulasi. Jadi aksi tidak muncul dari ruang kosong, melainkan dari konteks multimodal yang sudah dipahami bersama.
Buat pembaca non-teknis, bayangkan ada satu “otak” yang lebih fokus berpikir dan memahami instruksi, lalu ada satu “otak” lain yang lebih fokus membayangkan perubahan dunia dan tindakan. Keduanya terus bertukar informasi. Hasil akhirnya adalah sistem yang lebih cocok untuk tugas-tugas fisik dibanding model visual biasa.
NVIDIA juga menyoroti tantangan klasik di dunia robotika: tiap jenis mesin punya cara berbeda dalam mendefinisikan aksi. Mobil otonom biasanya memikirkan posisi kendaraan, kecepatan, dan orientasi. Robot lengan bicara soal posisi end-effector, sudut sendi, dan kondisi gripper. Sistem kamera robotik fokus pada gerak kamera. Kalau setiap jenis perangkat butuh format aksi yang benar-benar berbeda, membangun model fondasi lintas perangkat akan repot sekali.
Di sinilah Cosmos 3 mencoba menyederhanakan masalah dengan representasi aksi universal. Sumber resmi menjelaskan bahwa berbagai embodiment fisik dipetakan ke representasi aksi bersama yang mencakup tiga elemen utama: translasi, rotasi, dan status manipulasi.[1] Model card-nya juga mencantumkan dukungan untuk beberapa format aksi dan embodiment, termasuk camera motion, kendaraan otonom, serta sejumlah konfigurasi robot lengan seperti Franka, UR, dan WidowX.[1][2]
Pendekatan ini penting karena membuka jalan ke model yang lebih general-purpose. Developer tidak harus selalu mulai dari nol hanya karena robot yang dipakai berbeda. Selama representasi aksinya bisa dipetakan ke skema bersama, fondasi modelnya tetap konsisten. Tentu dalam praktik, performa akhir masih akan sangat bergantung pada data, fine-tuning, dan domain target. Tapi sebagai desain platform, ini langkah yang sangat strategis.
Hal lain yang cukup keren adalah cara Cosmos 3 Edge memandang video. Pada banyak model generatif, video pada dasarnya hanyalah keluaran visual: rangkaian frame yang tampak masuk akal. Pada Cosmos 3 Edge, video diperlakukan lebih “fisikal”. Ia bukan cuma visual yang cantik, tetapi representasi bagaimana dunia diperkirakan berubah setelah sebuah aksi dilakukan.[1] Jadi video berfungsi seperti simulasi konsekuensi.
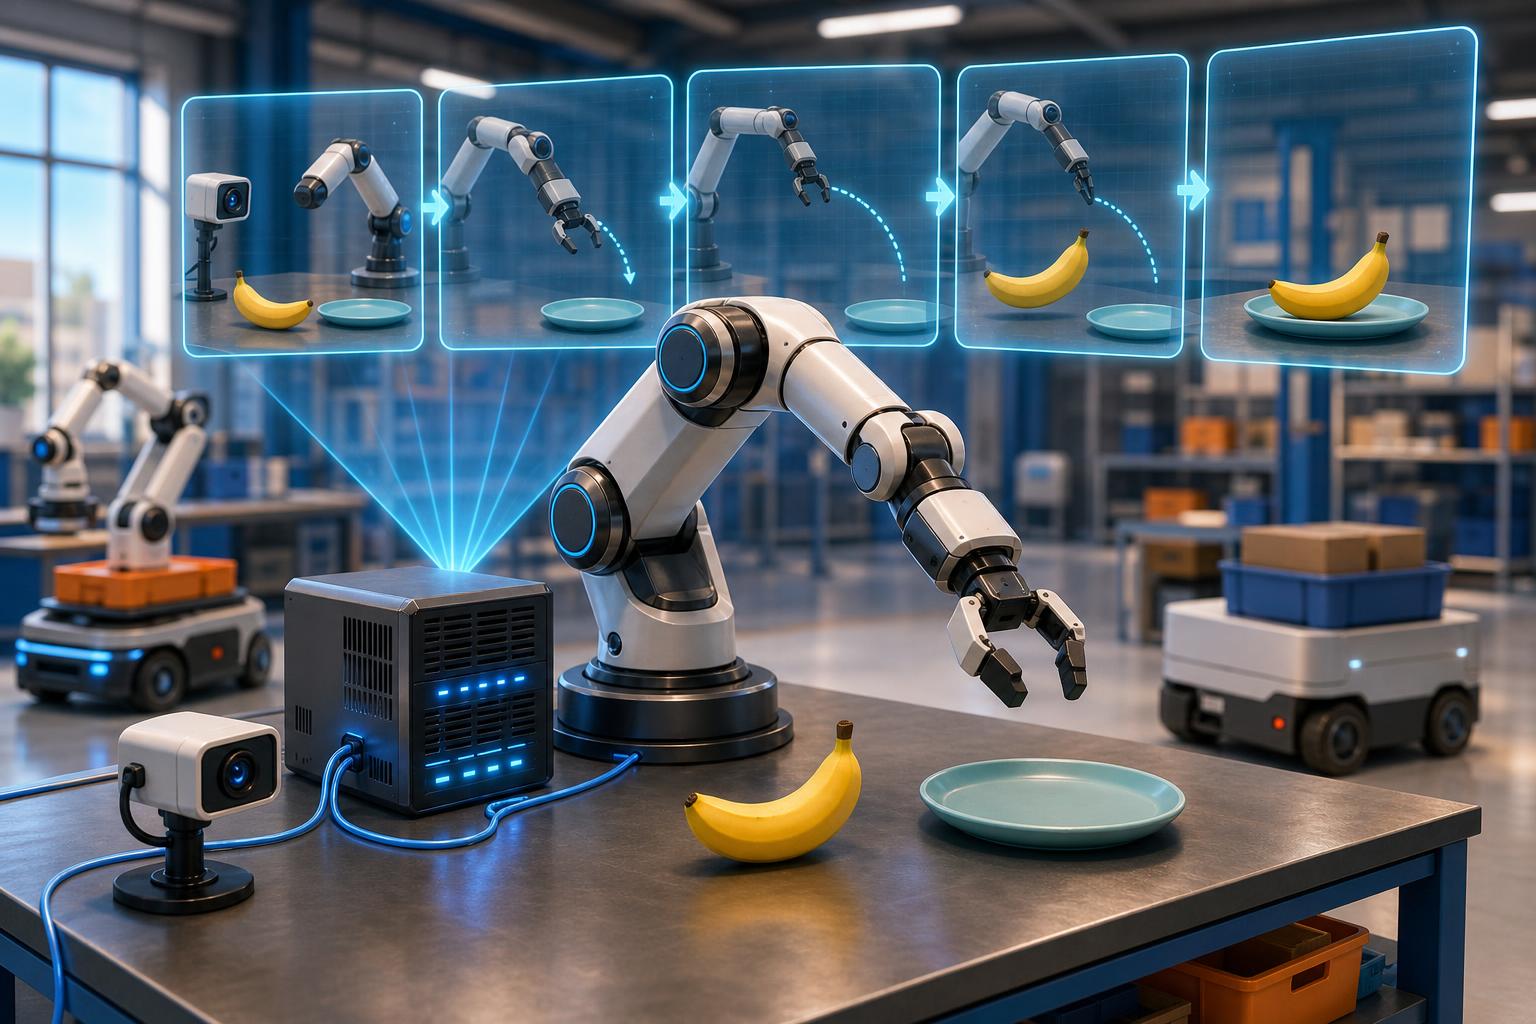
Misalnya robot diberi instruksi untuk mengambil pisang dan meletakkannya di piring. Dalam kerangka seperti ini, model bisa membantu menghasilkan aksi robot sekaligus memproyeksikan seperti apa perubahan visual dunia ketika aksi itu dijalankan.[1] Bagi proses pelatihan robot, ini menarik karena simulasi visual semacam itu dapat menjadi sumber sinyal tambahan untuk evaluasi maupun pembelajaran kebijakan.
NVIDIA menyebut salah satu mode pentingnya sebagai Policy Mode. Di sini model menghasilkan dua keluaran sekaligus: aksi robot dan konsekuensi visual yang diharapkan.[1] Jadi model tidak hanya berkata, “Lakukan gerakan A.” Model juga memberi konteks, “Kalau gerakan A dilakukan, dunia kemungkinan berubah menjadi seperti ini.” Dalam banyak skenario robot learning, kemampuan seperti ini sangat berharga karena membantu evaluasi kebijakan, eksplorasi tindakan, dan perencanaan yang lebih sadar konsekuensi.
Dari sudut pandang praktis, Policy Mode terasa seperti gabungan antara kontrol dan simulasi mini. Ini bukan berarti model tersebut otomatis aman untuk semua deployment fisik—karena tetap ada risiko, artefak, dan kebutuhan validasi—tetapi konsepnya memberi pondasi yang lebih kaya dibanding policy model yang hanya memetakan observasi ke aksi tanpa memikirkan konsekuensi visual secara eksplisit.
Untuk mendorong use case robot manipulasi, NVIDIA juga merilis Cosmos 3 Edge Policy (DROID). Versi ini merupakan hasil post-training pada dataset DROID dan ditujukan untuk aktivitas manipulasi robot seperti pick-and-place, mengambil objek, memindahkan objek, dan tugas manipulasi lain yang sejenis.[1] Menariknya, NVIDIA tidak hanya membuka modelnya, tetapi juga script post-training, recipe fine-tuning, dan alur kerja adaptasi model.[1][4]
Ini poin yang sering luput dari pembahasan publik. Dalam dunia AI terapan, akses ke bobot model saja belum cukup. Yang benar-benar membantu developer adalah akses ke pipeline: bagaimana melatih, mengevaluasi, menyajikan model, dan menyesuaikannya dengan data domain sendiri. Repositori resmi NVIDIA Cosmos menjelaskan dukungan workflow yang mencakup Diffusers dan Transformers untuk eksperimen Python-first, vLLM-Omni/vLLM/SGLang untuk serving, serta Cosmos Framework untuk training dan evaluasi.[4] Artinya, ekosistem di sekeliling model ini cukup serius dipersiapkan untuk pengembangan lanjutan.
Dari sisi performa di perangkat edge, ada beberapa angka penting yang didukung sumber resmi. Sebagai world action model hasil post-training, Cosmos 3 Edge bekerja pada resolusi kontrol robot 640 × 360, dapat menghasilkan 32 aksi robot dalam satu kali inferensi, dan mencapai 15 Hz pada NVIDIA Jetson Thor.[1] Untuk ukuran model fondasi yang menangani visual, aksi, dan dinamika dunia, angka ini cukup impresif dan relevan untuk banyak skenario real-time.
Perlu dicatat, angka-angka tersebut adalah klaim resmi NVIDIA yang tersedia pada materi publik mereka.[1] Ini layak dianggap sebagai indikasi kemampuan platform, tetapi pengguna tetap perlu mengujinya pada workload, hardware, sensor, dan kondisi aplikasi masing-masing. Dunia nyata sering kali lebih berisik daripada demo terkurasi.
NVIDIA juga menyatakan Cosmos 3 Edge meraih peringkat #1 pada VANTAGE-Bench untuk kategori vision analytics di kelas model sekitar 4B parameter, serta mencapai performa terbaik untuk robot policy learning.[1] Lagi-lagi, ini aman dibaca sebagai klaim vendor yang berasal dari sumber resmi per Juli 2026. Tanpa angka benchmark rinci yang dipaparkan di sini, kita sebaiknya menempatkan klaim tersebut sebagai sinyal bahwa NVIDIA ingin menunjukkan efisiensi tinggi di kelas ukuran model yang relatif ringkas.
Kalau klaim itu konsisten di lapangan, dampaknya bisa besar untuk area seperti:
- smart factory,
- gudang otomatis,
- rumah sakit,
- robot layanan,
- smart infrastructure,
- agen AI berbasis visi yang perlu bertindak, bukan hanya mengamati.
Masih dalam rangkaian pengumuman yang sama, NVIDIA juga merilis pembaruan penting untuk keluarga Cosmos 3 Super, yaitu Cosmos3-Super-Image2Video-4Step dan Cosmos3-Super-Text2Image-4Step.[1] Walaupun ini bukan fokus utama artikel, kabar ini tetap relevan karena menunjukkan strategi NVIDIA yang lebih luas: membuat model generatif fisik/visual semakin cepat dan semakin praktis dipakai.
Kedua model Super baru tersebut menggunakan teknik step distillation. Menurut NVIDIA, proses sampling yang sebelumnya membutuhkan sekitar 50 langkah denoising dipangkas menjadi hanya 4 langkah, tanpa penurunan kualitas visual yang signifikan.[1] Selain itu, pendekatan ini juga tidak lagi memerlukan classifier-free guidance dan menghasilkan efisiensi GPU yang lebih baik.[1]
Hasilnya, inferensi disebut bisa mencapai hingga 25 kali lebih cepat.[1] NVIDIA juga menyatakan bahwa per 23 Juli 2026, model distilled Image-to-Video tersebut berada di peringkat pertama pada leaderboard Artificial Analysis untuk kategori open-weight I2V, sedangkan versi Text-to-Image berada di peringkat kedua.[1] Lagi-lagi, ini adalah pernyataan resmi NVIDIA pada waktu tersebut, jadi paling aman bila disampaikan dengan atribusi yang jelas.
Kalau ditarik ke gambaran besar, semua ini menunjukkan satu arah: NVIDIA sedang membangun platform untuk physical AI, bukan hanya kumpulan model terpisah. Cosmos 3 Edge menjadi sisi yang dekat ke deployment edge dan tindakan dunia nyata. Cosmos 3 Super menyasar generasi multimodal berkecepatan tinggi. Sementara ekosistem repo dan framework memberi jalan untuk fine-tuning, post-training, distillation, dan serving.[1][4]
Namun artikel yang bagus tidak seharusnya cuma terdengar promosi, jadi ada batasan penting yang juga perlu disebut. NVIDIA sendiri mengingatkan bahwa Cosmos 3 masih bisa menghasilkan artefak, terutama pada output panjang, resolusi tinggi, atau skenario fisik yang kompleks.[4] Contohnya bisa berupa inkonsistensi temporal, gerak kamera atau objek yang tidak stabil, ketidaksesuaian antara aksi dan state, morfing objek, struktur 3D yang kurang akurat, sampai dinamika fisik yang tidak masuk akal.[4]
Ini penting sekali. Sebab ketika model seperti ini digunakan untuk robot atau simulasi dunia nyata, kesalahan kecil tidak selalu berakhir kecil. Dalam konteks safety-critical, prediksi yang terlihat “cukup bagus” secara visual belum tentu aman dipakai sebagai dasar kontrol fisik langsung. Karena itu NVIDIA merekomendasikan validasi tambahan, guardrail, dan analisis keselamatan pada level sistem, khususnya untuk deployment yang benar-benar berisiko.[4]
Dengan kata lain, Cosmos 3 Edge bukan tombol ajaib yang langsung membuat semua robot menjadi cerdas dan aman. Ia lebih tepat dilihat sebagai fondasi yang sangat menjanjikan. Kelebihannya ada pada kombinasi langka: ukuran model relatif kompak, fokus pada dunia nyata, dukungan multimodal, kemampuan world/action modeling, efisiensi untuk edge, dan keterbukaan akses yang membuat komunitas bisa ikut bereksperimen.[1][2][3][4]
Dari sudut pandang industri, potensi manfaatnya cukup jelas. Di pabrik, model seperti ini bisa membantu robot memahami urutan kerja dan konsekuensi tindakan dengan lebih baik. Di gudang, ia bisa berguna untuk manipulasi barang dan navigasi berbasis situasi aktual. Di rumah sakit, sistem otomatis dapat memperoleh konteks visual yang lebih dinamis. Di kendaraan otonom dan infrastruktur pintar, world model semacam ini relevan untuk membaca perubahan lingkungan dan menghubungkan observasi dengan tindakan.[1][3]
Dari sudut pandang riset, Cosmos 3 Edge juga menarik karena mempertemukan beberapa jalur yang sebelumnya sering berjalan sendiri-sendiri: VLM, generative world model, simulasi visual, policy learning, dan edge deployment. Biasanya developer harus merangkai banyak komponen berbeda untuk mendekati kemampuan seperti ini. Di sini, NVIDIA mencoba menyatukannya dalam satu fondasi yang bisa dipost-training sesuai domain.[1][4]
Tentu masih ada pekerjaan rumah. Seberapa stabil model ini di lingkungan berantakan? Seberapa baik performanya di sensor non-ideal? Berapa biaya adaptasinya untuk robot yang benar-benar berbeda? Sejauh mana generalisasi lintas domain bisa dipertahankan setelah fine-tuning? Jawaban detail untuk pertanyaan-pertanyaan itu tidak tersedia lengkap dalam materi sumber yang kita pakai di sini, jadi paling jujur adalah mengakui bahwa evaluasi lanjut tetap diperlukan.[1][4]
Meski begitu, sinyal besarnya tetap kuat: masa depan AI visual tampaknya bergerak dari “mengenali” ke “memahami dan bertindak”. Cosmos 3 Edge adalah contoh konkret dari pergeseran itu. Ia dibangun bukan cuma untuk menjawab apa isi sebuah frame, melainkan untuk membantu mesin mengaitkan persepsi, penalaran, prediksi, dan aksi dalam konteks dunia fisik.[1][3]
Buat developer, kabar baiknya adalah aksesnya tidak dikunci rapat. Model tersedia publik di Hugging Face, dokumentasi dan workflow ada di GitHub, dan pendekatan post-training-nya juga dibuka.[1][2][4] Itu berarti eksperimen tidak harus berhenti di level membaca pengumuman produk. Komunitas bisa benar-benar menguji, mengadaptasi, dan menilai sendiri apakah fondasi ini cocok untuk kebutuhan mereka.
Kalau harus diringkas dalam satu kalimat, Cosmos 3 Edge terasa seperti langkah NVIDIA untuk membawa world model keluar dari pusat data dan masuk ke perangkat yang benar-benar berinteraksi dengan dunia. Dan kalau tren ini terus matang, robot masa depan mungkin tidak lagi hanya “melihat” lingkungan—mereka akan semakin mampu memahami perubahan, memperkirakan hasil tindakan, lalu merespons dengan lebih cerdas di tempat kejadian.
Pada akhirnya, itulah alasan kenapa rilis ini layak diperhatikan. Bukan semata karena angkanya 4B, bukan cuma karena nama besar NVIDIA, tetapi karena Cosmos 3 Edge memperjelas arah baru Physical AI: model yang efisien, multimodal, sadar dinamika dunia, siap untuk edge, dan cukup terbuka untuk dijadikan fondasi eksperimen nyata.[1][2][3][4]