Dalam banyak diskusi tentang adopsi AI, perhatian sering berhenti pada satu pertanyaan: model mana yang paling pintar? Perusahaan membandingkan GPT, Claude, Gemini, Llama, Qwen, dan model lain berdasarkan kemampuan menjawab, menulis, atau menganalisis. Namun, dalam praktik implementasi, kecerdasan model saja tidak otomatis menghasilkan sistem yang efektif. Dua tim dapat memakai model yang sama, tetapi memperoleh hasil yang sangat berbeda dari sisi kualitas, kecepatan, keamanan, dan konsistensi. Perbedaan itu sering bukan berasal dari model, melainkan dari sistem kerja yang dibangun di sekelilingnya.
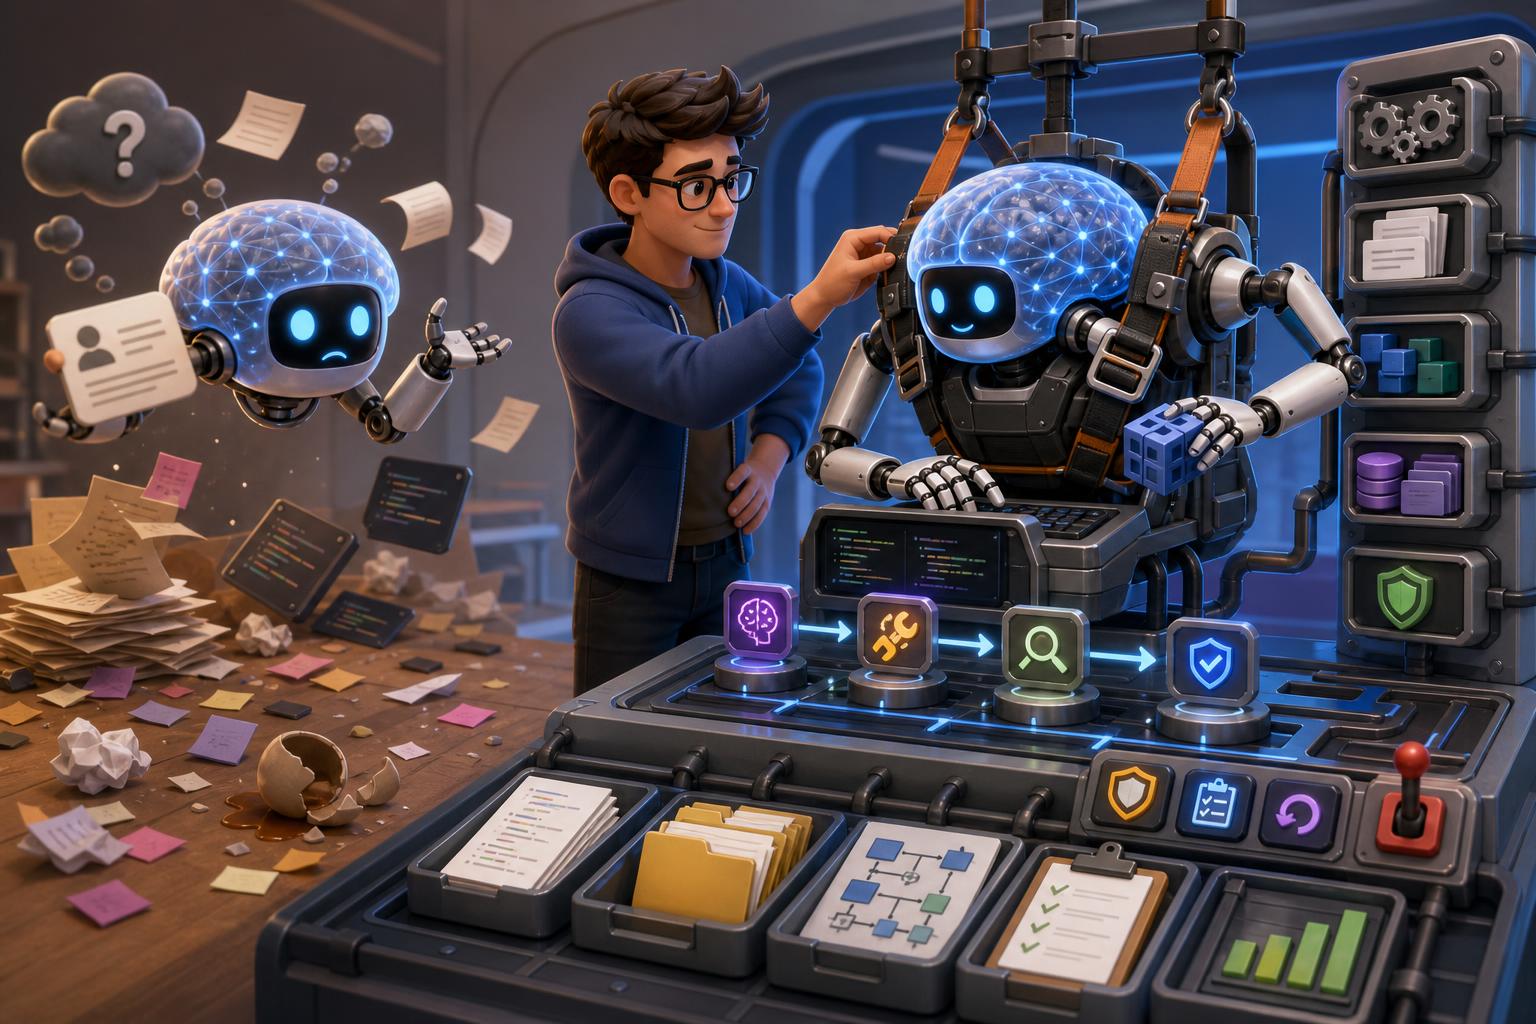
Di sinilah konsep harnessing menjadi penting. Secara sederhana, LLM dapat dipahami sebagai otak, sedangkan harness adalah lingkungan kerja yang membuat otak itu mampu bekerja secara nyata. Harness mencakup instruksi, akses tool, konteks, memori, workflow, evaluasi, dan guardrails. Rumus ringkasnya adalah: AI Agent = LLM + Tools + Context + Memory + Workflow + Guardrails + Evaluation. Tanpa susunan itu, model hanya menghasilkan respons; dengan susunan itu, model dapat menjadi agent yang mampu menjalankan tugas bertahap dan terverifikasi.
Karena itu, kemampuan prompt engineering tetap penting, tetapi tidak cukup. Prompting membantu mengarahkan cara model berpikir: apa tujuan tugas, format jawaban, batasan, dan konteks minimum. Akan tetapi, pekerjaan nyata jarang selesai hanya dengan satu instruksi yang baik. Saat agent diminta memperbaiki bug, meninjau repository, menjalankan test, memeriksa dependency, membandingkan perubahan, lalu memperbaiki hasil jika gagal, kebutuhan utamanya bukan lagi sekadar prompt yang rapi, melainkan sistem yang memungkinkan seluruh langkah itu terjadi secara aman dan berulang.
Dengan kata lain, prompting mengatur apa yang diminta dari model, sedangkan harnessing mengatur bagaimana model bekerja. Pergeseran ini semakin jelas dalam tulisan OpenAI tentang harness engineering. OpenAI menjelaskan bahwa ketika agent mengambil porsi pekerjaan coding yang besar, tugas engineer bergeser dari menulis kode secara langsung menjadi merancang environment, menspesifikkan intent, dan membangun feedback loop agar agent bekerja konsisten [1]. Dalam eksperimen yang mereka paparkan, tim Codex bahkan menyebut produk internal dibangun dengan kode, testing, konfigurasi, dokumentasi, observability, dan tools internal yang ditulis oleh agent, sementara manusia memegang peran penentu tujuan dan perancang lingkungan kerjanya [1].
Fakta tersebut penting karena menunjukkan satu hal: model pintar belum tentu melahirkan sistem yang andal bila lingkungannya buruk. Bayangkan dua coding agent menggunakan LLM yang sama. Agent pertama hanya menerima instruksi, “Perbaiki bug pada aplikasi ini.” Agent kedua bekerja dengan repository terstruktur, dokumentasi arsitektur, file instruksi seperti AGENTS.md, akses terminal, perintah build, test runner, static analysis, aturan keamanan, dan mekanisme review. Secara analitis, sangat masuk akal bila agent kedua menghasilkan pekerjaan yang lebih konsisten dan lebih mudah diverifikasi. Bukan karena otaknya berbeda, tetapi karena lingkungan kerjanya lebih lengkap dan lebih jelas.
Landasan ilmiah untuk cara kerja seperti ini dapat dilihat pada riset ReAct. Penelitian tersebut menunjukkan pola agent modern yang tidak hanya menjawab, tetapi juga menjalankan siklus reasoning → action → observation → reasoning berikutnya [4]. Model tidak berhenti pada penjelasan internal. Ia dapat mengambil tindakan ke sumber eksternal, melihat hasilnya, lalu memperbarui rencana. ReAct dilaporkan membantu mengurangi masalah halusinasi dan propagasi error yang kerap muncul pada pendekatan reasoning tanpa aksi eksternal [4]. Artinya, agent yang efektif bukan hanya yang pandai “berpikir”, tetapi yang mampu berpikir sambil bertindak dan memeriksa kenyataan.
Argumen bahwa lingkungan kerja memengaruhi kemampuan agent juga diperkuat oleh SWE-agent. Penelitian ini secara eksplisit menyoroti pentingnya agent-computer interface yang dirancang khusus agar model dapat menavigasi repository, membaca file, mengedit kode, menjalankan program, dan memahami hasil terminal [5]. Temuan itu relevan untuk dunia kerja saat ini: peningkatan performa agent tidak selalu datang dari model yang lebih besar, tetapi bisa berasal dari desain interface dan harness yang lebih tepat. Dalam konteks software engineering, desain lingkungan yang legible, testable, dan auditable dapat menjadi keunggulan yang lebih bernilai daripada sekadar mengganti model.
Anthropic memberi nuansa penting pada diskusi ini melalui pembedaan antara workflow dan agent. Menurut mereka, workflow adalah sistem ketika LLM dan tools diorkestrasi melalui jalur yang telah ditentukan, sedangkan agent adalah sistem ketika LLM memiliki kendali lebih dinamis untuk memilih proses dan penggunaan tool [2]. Anthropic juga menekankan bahwa implementasi yang paling sukses sering justru dimulai dari pola yang sederhana dan composable, bukan dari kompleksitas agentic yang berlebihan [2]. Ini penting sebagai koreksi: harness engineering bukan ajakan membuat sistem serumit mungkin, melainkan membangun struktur secukupnya agar tugas benar-benar bisa selesai.
Persoalan harness menjadi lebih kentara pada pekerjaan berdurasi panjang. Anthropic menjelaskan bahwa frontier coding models yang dijalankan lintas banyak context window dapat tetap gagal bila hanya diberi prompt tingkat tinggi [3]. Mereka menyebut dua failure mode yang sangat praktis: agent mencoba mengerjakan terlalu banyak sekaligus lalu kehabisan konteks dan meninggalkan state setengah jadi; atau agent berikutnya melihat ada progres, lalu salah menyimpulkan pekerjaan telah selesai [3]. Solusi yang mereka bahas berada pada level harness: menyiapkan fondasi awal, memecah kerja secara inkremental, menjaga kebersihan workspace, dan meninggalkan artefak progres yang jelas untuk sesi berikutnya [3]. Di sini terlihat bahwa dokumentasi bukan hanya untuk manusia, tetapi juga berfungsi sebagai memori operasional bagi agent.
Dari sudut implementasi perusahaan, komponen harness yang baik umumnya mencakup beberapa lapisan berikut:
- Instructions: system prompt, aturan kerja, definition of done, acceptance criteria.
- Context: repository, spesifikasi, dokumentasi arsitektur, riwayat perubahan.
- Tools: terminal, browser, Git, database client, API client, test runner.
- Memory: progress file, decision log, task history, session summary.
- Guardrails: sandbox, pembatasan akses, approval manusia, pengelolaan secrets.
- Evaluation: unit test, integration test, static analysis, review manusia.
- Recovery: retry, rollback, reflection, handoff ke manusia atau agent lain.
Secara analitis, inilah alasan mengapa organisasi tidak cukup hanya memberi akses chatbot kepada karyawan. Tanpa harness yang jelas, AI mudah menghasilkan output tidak konsisten, perubahan tanpa jejak audit, penggunaan data yang berisiko, serta hasil yang sulit direproduksi. Sebaliknya, dengan harness, organisasi dapat menetapkan sumber data resmi, standar dokumentasi, workflow kerja, quality gate, batas akses, dan mekanisme rollback. Pada titik itu, AI tidak lagi menjadi eksperimen personal, melainkan kapabilitas organisasi yang lebih terstruktur.
Hal yang juga perlu ditegaskan adalah batasannya. Istilah harness engineering sendiri belum menjadi istilah akademik baku yang mapan seperti prompt engineering; penggunaan paling eksplisit saat ini datang dari praktik engineering OpenAI [1]. Selain itu, bukti paling kuat dalam sumber yang tersedia memang banyak berasal dari domain coding dan agentic software work [1][3][5]. Karena itu, generalisasi ke seluruh use case bisnis perlu dilakukan dengan hati-hati. Tidak semua pekerjaan membutuhkan agent penuh, dan tidak semua persoalan memerlukan harness yang kompleks. Dalam banyak kasus, workflow sederhana justru lebih tepat [2].
Kesimpulannya jelas. Prompt engineering masih penting karena membantu model memahami instruksi dengan lebih baik. Namun, ketika targetnya adalah AI agent yang harus bekerja lintas banyak langkah, memakai tool, memeriksa hasil, mengingat progres, dan melanjutkan tugas dengan aman, prompt saja tidak cukup. Keandalan sistem lebih banyak ditentukan oleh kualitas harness di sekeliling model: interface, dokumentasi, memori, evaluasi, dan guardrails [1][3][5]. LLM memberi kecerdasan, tetapi harness mengubah kecerdasan itu menjadi kerja nyata yang terukur dan dapat diverifikasi. Bagi perusahaan, keunggulan berikutnya bukan sekadar memilih model paling pintar, melainkan membangun lingkungan kerja agent yang paling jelas, paling aman, dan paling dapat diaudit.
Referensi: [1] OpenAI, Harness engineering: leveraging Codex in an agent-first world. [2] Anthropic, Building effective agents. [3] Anthropic, Effective harnesses for long-running agents. [4] Yao dkk., ReAct: Synergizing Reasoning and Acting in Language Models. [5] Yang dkk., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering.
Sumber Referensi
- Harness engineering: leveraging Codex in an agent-first world | OpenAI
- Building effective agents | Anthropic
- Effective harnesses for long-running agents | Anthropic
- ReAct: Synergizing Reasoning and Acting in Language Models | arXiv
- SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering | arXiv