Dalam dunia kecerdasan buatan yang semakin canggih, dua model besar muncul dengan pendekatan berbeda dalam menyelesaikan masalah pemahaman bahasa: DeepSeek V3/R1 dan Kimi K2. Kedua model ini dirancang menggunakan konsep Mixture of Experts (MoE), yaitu pendekatan di mana hanya sebagian kecil dari neuron (disebut "experts") yang aktif saat memproses suatu input, sehingga lebih efisien secara komputasi. Namun, meskipun berbagi konsep dasar yang sama, DeepSeek dan Kimi K2 mengambil jalur yang berbeda dalam desain arsitekturnya—bagaikan dua perusahaan besar yang memilih strategi manajemen yang berbeda untuk mencapai tujuan yang sama.
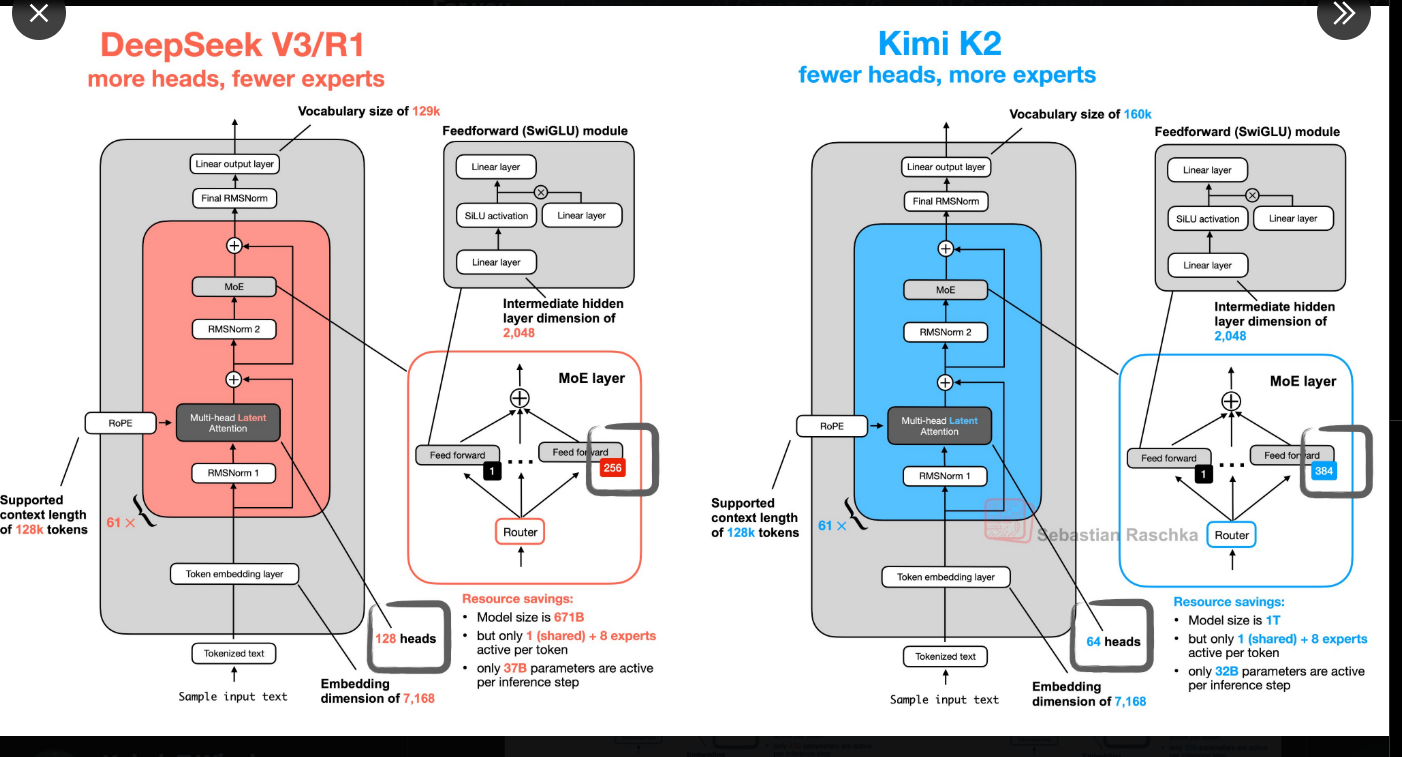
Sumber https://x.com/rasbt/status/1944056316424577525
Analogi: Detektif vs Tim Spesialis
Bayangkan kamu memimpin dua perusahaan raksasa yang harus menganalisis jutaan dokumen setiap hari. Di perusahaan pertama, yang menggunakan pendekatan DeepSeek, kamu mempekerjakan banyak pengamat (128 heads)—mirip seperti memasang 128 kamera CCTV yang mengamati ruangan dari berbagai sudut. Pengamatan ini memungkinkan perusahaan memahami konteks dengan detail luar biasa. Namun, untuk menyelesaikan pekerjaan spesifik, kamu hanya memiliki sedikit ahli (256 experts) yang harus berbagi tugas.
Sementara itu, di perusahaan kedua yang menggunakan pendekatan Kimi K2, jumlah pengamat dikurangi menjadi hanya 64 kamera (64 heads), tetapi kamu merekrut jauh lebih banyak spesialis—yakni 384 experts. Setiap dokumen yang masuk akan diproses oleh segelintir ahli pilihan yang paling cocok untuk tugas tersebut, walaupun kamu tidak punya sebanyak itu pengamat yang melihat dari berbagai sudut. Inilah esensi dari strategi “fewer heads, more experts” yang digunakan oleh Kimi K2, berbanding terbalik dengan strategi “more heads, fewer experts” yang digunakan oleh DeepSeek.
Cara Kerja Mixture of Experts
Di balik layar, kedua model ini menggunakan arsitektur MoE. Pada dasarnya, setiap input token yang masuk tidak diproses oleh semua neuron atau lapisan, melainkan hanya oleh 1 router dan 8 experts yang dipilih secara cerdas dari ratusan kandidat. Ini sangat efisien, karena daripada mengaktifkan seluruh jaringan saraf, model hanya mengaktifkan bagian-bagian kecil yang paling relevan. Akibatnya, meskipun ukuran total model besar, jumlah parameter yang benar-benar bekerja pada satu langkah (inference step) bisa jauh lebih kecil.
Pada DeepSeek, model memiliki total 671 miliar parameter, dan yang aktif dalam satu langkah hanya 37 miliar. Sedangkan Kimi K2 lebih besar secara keseluruhan, mencapai 1 triliun parameter, tetapi lebih hemat dalam penggunaan saat beroperasi: hanya 32 miliar parameter yang aktif per langkah. Ini seperti memiliki pasukan besar, tapi hanya mengerahkan unit khusus setiap kali misi dimulai.
Dimensi dan Kapasitas
Baik DeepSeek maupun Kimi K2 menggunakan dimensi embedding yang sama besar, yakni 7.168, serta hidden layer berukuran 2.048. Ini berarti keduanya memiliki kapasitas internal yang sangat tinggi dalam merepresentasikan dan memahami bahasa. Keduanya juga mendukung panjang konteks ekstrem hingga 128.000 token, memungkinkan mereka membaca novel panjang, dokumen riset ilmiah, atau riwayat percakapan dalam satu konteks penuh tanpa kehilangan pemahaman.
Namun, satu perbedaan mencolok adalah ukuran kosakata (vocabulary size). DeepSeek menggunakan 129.000 kata, sedangkan Kimi K2 mencapai 160.000 kata, yang menunjukkan bahwa Kimi K2 mungkin lebih fleksibel dalam menangani beragam bahasa dan bentuk teks.
Efisiensi dan Tujuan
Jika kita berbicara efisiensi, Kimi K2 sedikit lebih unggul karena mampu menghemat lebih banyak parameter saat beroperasi. Ini berkat jumlah expert yang lebih banyak, sehingga pilihan rute pemrosesan bisa lebih tepat sasaran. Tapi DeepSeek memiliki keunggulan dalam hal jumlah perhatian yang bisa diberikan ke berbagai aspek teks melalui 128 attention heads—yang berarti lebih jeli dalam mengamati nuansa, urutan, dan struktur bahasa.
Kita bisa menyimpulkan bahwa DeepSeek lebih cocok untuk tugas-tugas yang menuntut pemahaman mendalam dan multi-perspektif (misalnya pemrosesan teks legal, analisis logika kompleks, atau diskusi ilmiah), sementara Kimi K2 unggul dalam efisiensi dan adaptabilitas dalam skala besar, seperti menjawab permintaan pengguna secara cepat dalam skenario real-time seperti chatbot atau asisten digital.
Kesimpulan: Dua Strategi, Satu Tujuan
DeepSeek V3/R1 dan Kimi K2 adalah dua mahakarya arsitektur AI masa kini yang menunjukkan bahwa tidak ada satu jalur benar dalam membangun kecerdasan buatan. Satu memilih banyak mata dan sedikit otak, satu lagi memilih sedikit mata dan banyak otak. Sama seperti manusia yang bekerja dengan gaya berbeda—ada yang sangat teliti dan analitis, ada yang mengandalkan intuisi dan keahlian khusus—kedua model ini mendemonstrasikan bagaimana AI bisa berkembang lewat beragam pendekatan desain. Yang pasti, keduanya membuktikan bahwa masa depan AI tidak hanya soal siapa yang lebih besar, tapi juga siapa yang lebih bijak menggunakan kapasitasnya.