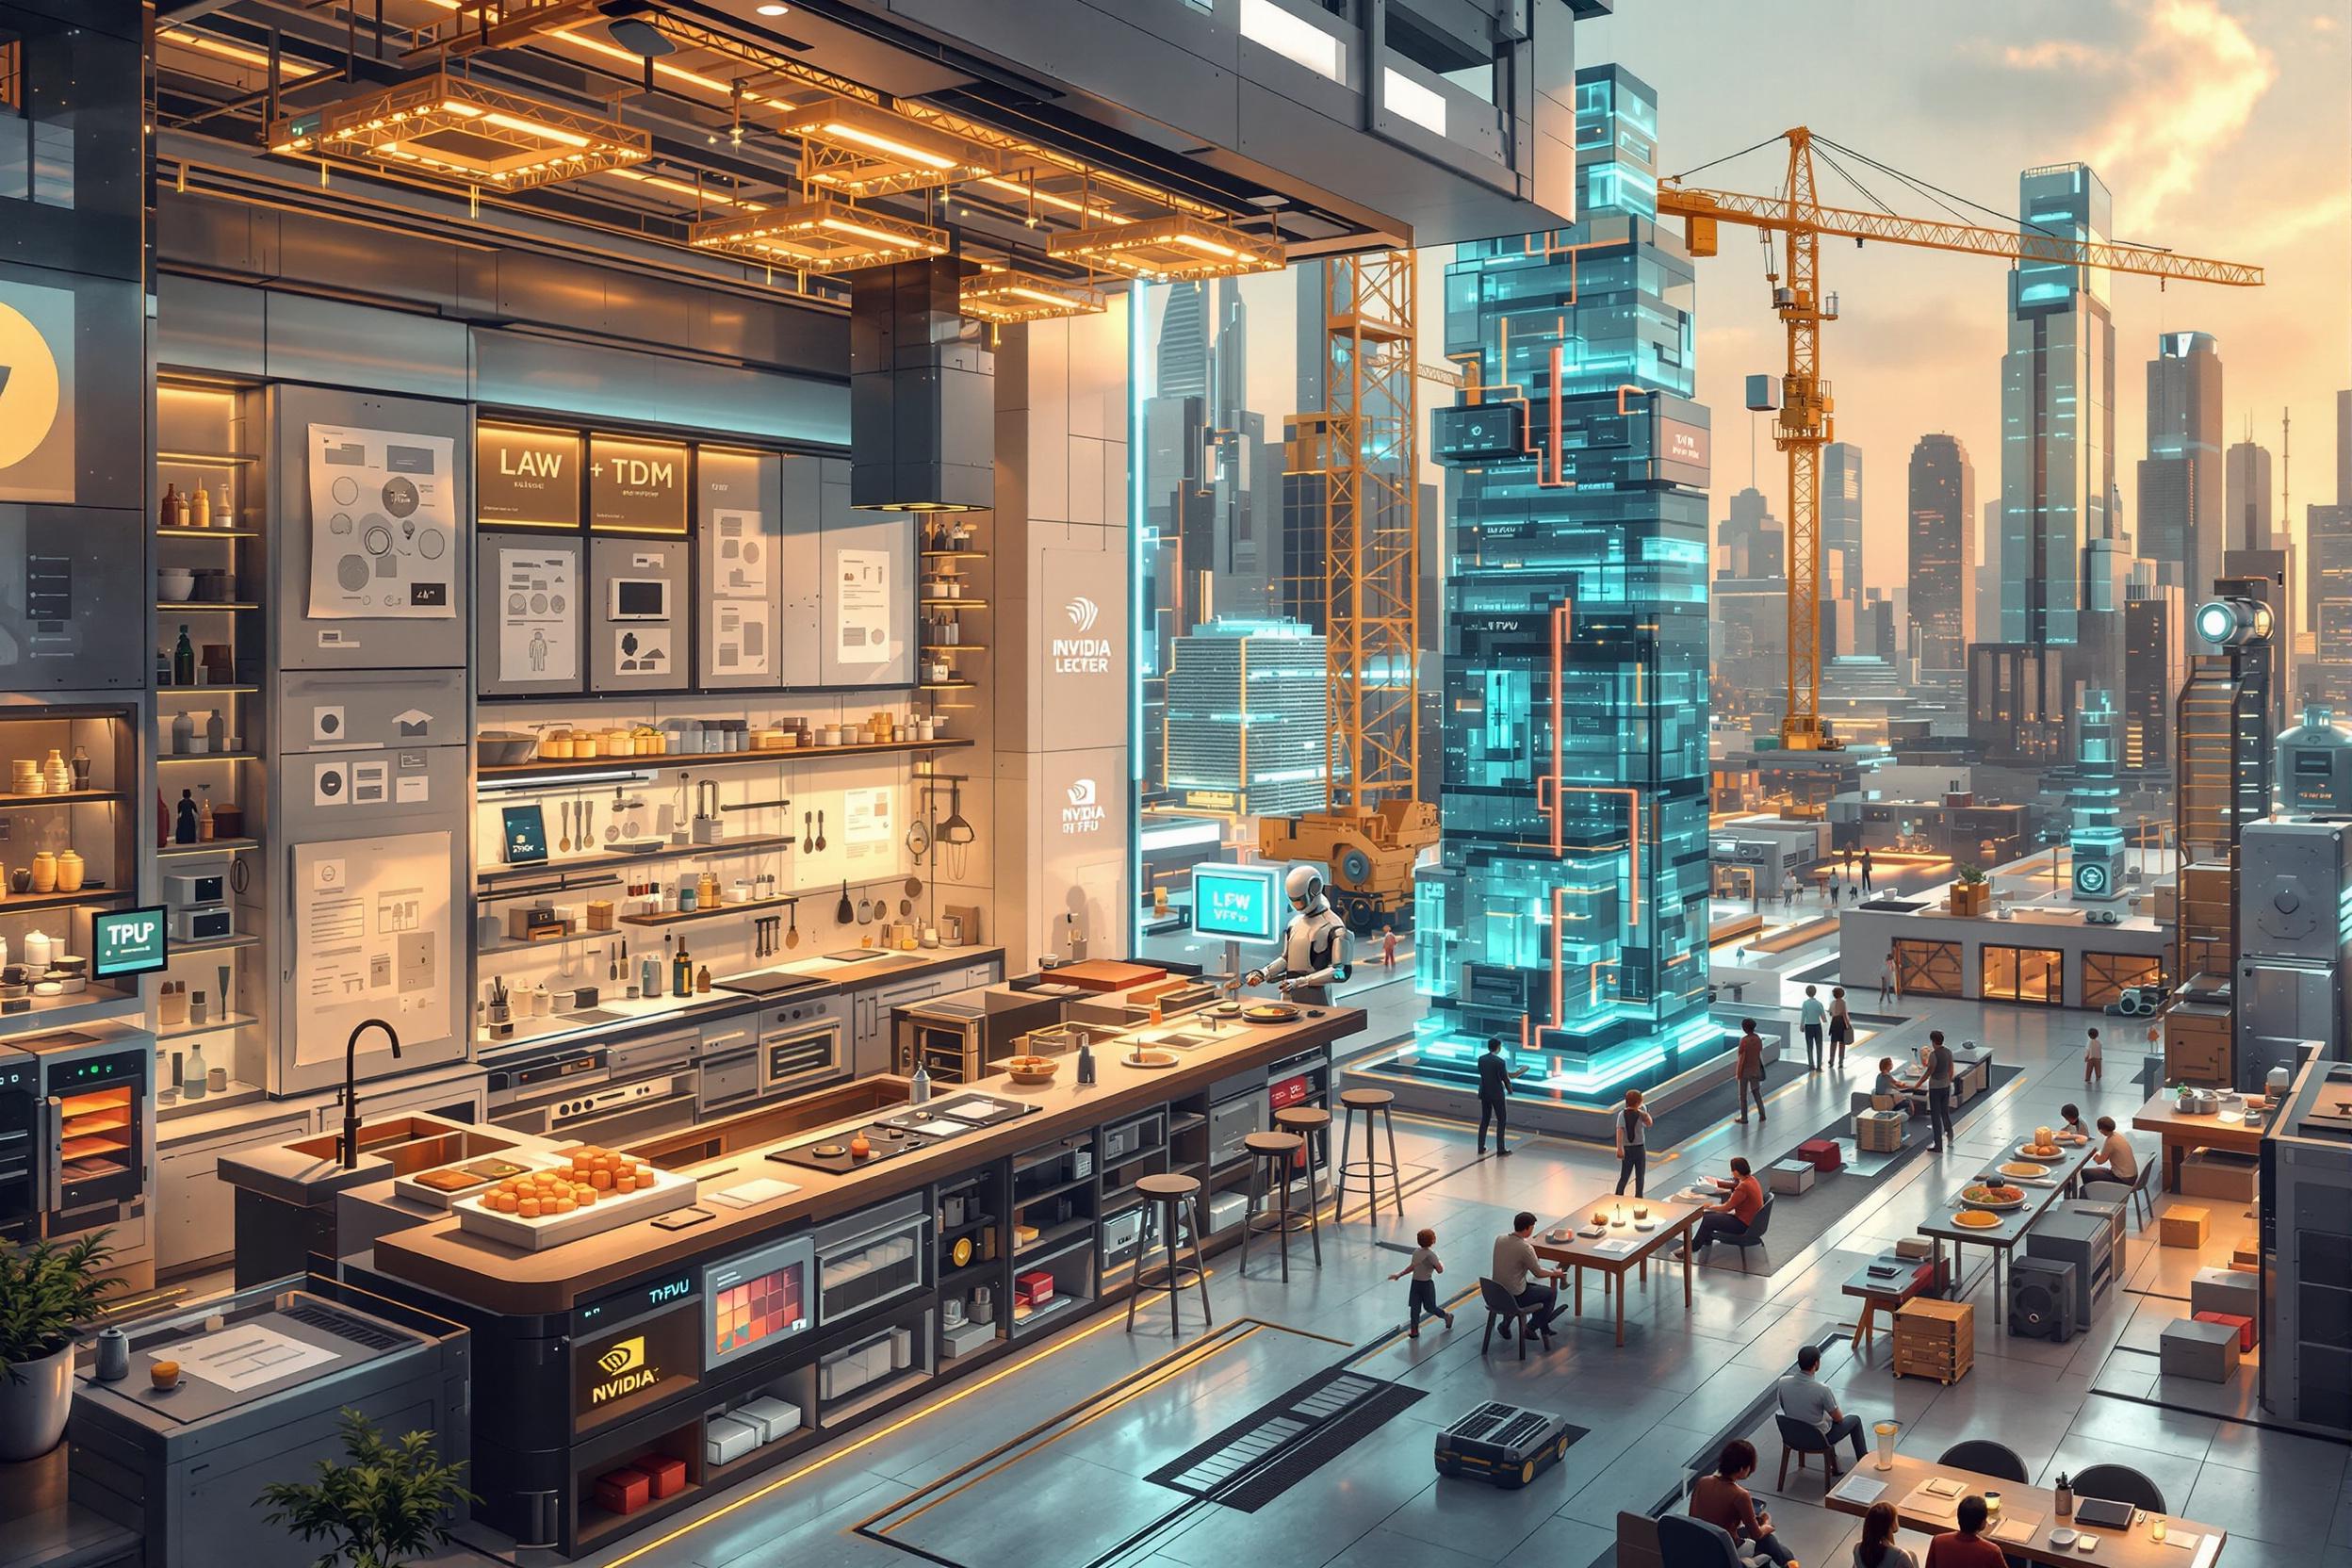
Bro, pernah nggak sih kepikiran buat bikin Large Language Model (LLM) sendiri? Kayak punya chef robot pribadi yang bisa masak resep rahasia kamu tanpa takut bocor ke orang lain. Ini bukan cuma soal keren-kerenan teknologi, tapi juga soal dapetin kontrol penuh atas data dan inovasi yang kamu mau.
Bayangin nih, kalau kamu punya restoran dengan chef robot yang bisa kamu latih ulang sesuka hati. Resep rahasia? Itu data internal yang nggak boleh bocor kemana-mana. Chef robot itu model AI yang kamu latih dengan data kamu sendiri. Dapur sendiri? Artinya kamu nggak perlu bayar royalti API tiap kali mau sajikan menu AI kamu.
Kenapa sih ribet-ribet bikin LLM sendiri? Nih alasan utama yang bikin kamu harus pertimbangin:
- Kerahasiaan & Kepatuhan: Data sensitif perusahaan tetap di rumah, aman banget dari kebocoran.
- Spesialisasi Domain: Model bisa ngobrol pake "bahasa hukum", "bahasa properti", atau dialek lokal tanpa halu alias ngawur.
- Efisiensi Biaya Jangka Panjang: Sekali bangun model, biaya inference bisa jauh lebih murah dibanding bayar token API tiap kali pakai.
- Kedaulatan Teknologi: Nggak tergantung vendor asing, penting banget buat riset nasional dan regulasi pemerintah.
- Inovasi Produk: Bisa otak-atik fitur daring-luring kayak multimodal, voice, plug-in tanpa nunggu roadmap orang lain.
Membangun LLM itu ibarat bikin kota digital yang canggih. Nih gambaran prosesnya:
| Tahap Konstruksi | Apa yang Terjadi | Analogi Kota |
|---|---|---|
| 1. Visi & RAB | Tentukan misi, jumlah parameter, target bahasa | Cetak-biru masterplan |
| 2. Tambang Data | Kumpulkan, bersihkan, timbang proporsi data | Menambang & menyaring pasir |
| 3. Tokenisasi | Pecah teks jadi potongan LEGO | Potong batu bata |
| 4. Arsitektur | Pilih rangka Transformer, MoE, konteks panjang | Desain rangka gedung & lift |
| 5. Infrastruktur | Sewa atau rakit klaster GPU/TPU | Beli crane & beton-mixer |
| 6. Training | Tuang beton lapis demi lapis (gradient step) | Cor lantai gedung |
| 7. Evaluasi + Alignment | Stress-test, red-team, RLHF | Uji gempa & atur peraturan kota |
| 8. Deploy & Monitor | vLLM serving, observability, update berkala | Buka gerbang & pasang CCTV |
Cuplikan Referensi Teknis yang Wajib Kamu Tahu:
| Topik | Sumber | Inti Temuan |
|---|---|---|
| Scaling law “Chinchilla” | Hoffmann et al. 2022 (arXiv) | Model optimal = parameter sebanding dengan data, jangan cuma gede tapi juga banyak datanya |
| Penghematan memori ZeRO-3 | DeepSpeed docs (DeepSpeed) | Optimizer & grad bisa di-offload ke CPU/NVMe, hemat memori banget |
| GPU era Blackwell B100 | NVIDIA press release (NVIDIA Newsroom) | 25× lebih hemat watt dibanding H100 buat LLM triliun-parameter |
| TPU v5p / Trillium | Google Cloud notes (Google Cloud) | Skalanya ratusan ribu accelerator buat satu job super besar |
| Infrastruktur inference cepat | GitHub vLLM (GitHub) | KV-cache paging meningkatkan throughput 2-3x dibanding GPT-style |
| MoE efisien | MegaBlocks paper (arXiv) | 40% speed-up sparse-expert dibanding dense |
Gimana sih jalur singkat buat mulai bikin LLM? Nih, helikopter-view-nya:
- Tentukan ukuran model: Buat chatbot internal 1B parameter cukup pakai 1×H100. Kalau mau produk publik 70B parameter, siap-siap klaster 8-64×A100 selama sebulan training.
- Data hygiene: Ambil data dari Common Crawl, Wikipedia, dan dokumen internal. Lalu deduplikasi pake SimHash, buang info pribadi (PII), dan seimbangkan bahasa.
- Arsitektur: Pakai decoder-only Transformer, tambahin RoPE atau ALiBi buat konteks panjang. Kalau model >30B, pertimbangin MoE buat hemat watt.
- Optimasi training: Gunakan bf16 atau FP8 precision; ZeRO-3-Offload kalau model jumbo. Scheduler pakai warm-up linear yang diikuti cosine decay; checkpoint streaming ke cloud storage.
- Evaluasi & Alignment: Pastikan perplexity <3 di valid set dan MMLU naik stabil. Lakukan red-team, filter bias, dan RLHF dengan konstitusi internal.
- Serving: Deploy pakai vLLM, kompres model ke 4-bit (QLoRA) untuk edge device. Pasang tracing token-level dan rollback otomatis kalau respons aneh.
Penutup: Apakah layak bikin LLM sendiri?
Kalau layanan kamu cuma butuh respon umum, sewa API SaaS mungkin udah cukup, bro. Tapi kalau:
- Data kamu sensitif,
- Domain kamu spesifik banget,
- Butuh latensi rendah lokal, atau
- Biaya API mulai makin mahal,
Membangun otoritas otak digital sendiri itu investasi yang smart banget. Teknologi 2025 kayak Blackwell, ZeRO-3, dan vLLM bikin proses ini makin cepat dan efisien. Tapi jangan lupa, keamanan, etika, dan pemeliharaan tetap jadi fondasi utama supaya restoran chef robot kamu tetap aman dan higienis.
Selamat merancang dan membangun! Semoga restoran chef-robot kamu ramai pelanggan dan tetap aman higienis! 🍳🤖