Oke gengs, kita bakal bahas tentang back propagation, si jagoan di balik pembelajaran mesin alias machine learning, khususnya di neural networks. Tapi santuy, gue bakal jelasin dengan bahasa yang gampang dan gaya yang asik supaya kamu makin paham dan nggak bosen.
Jadi, apa sih back propagation itu?
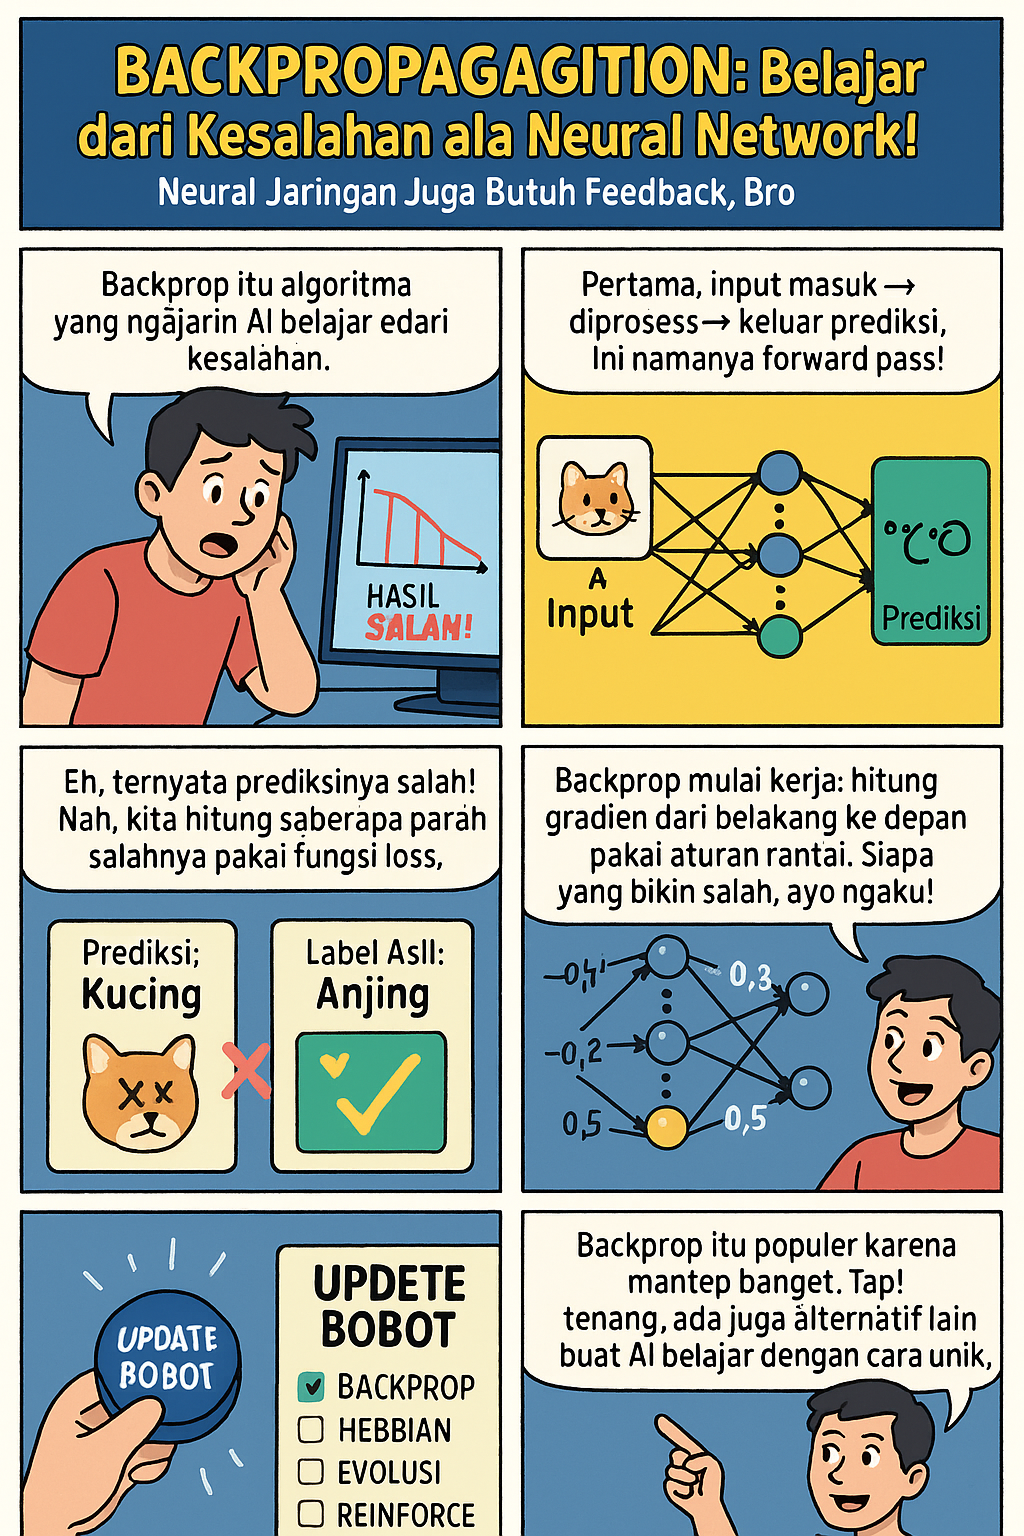
Back propagation atau biasa disingkat backprop adalah algoritma yang dipakai buat ngasih tahu jaringan saraf tiruan (neural network) gimana cara nge-update bobot-bobotnya supaya hasil prediksi makin oke. Intinya, backprop ini kayak guru yang ngingetin neural network tentang kesalahan yang dia buat, terus ngasih tahu langkah apa yang harus diambil supaya kesalahan itu berkurang.
Gimana sih cara kerja backprop?
Mari kita bedah step by step, biar makin jelas:
- 1. Forward Pass (Jalan Maju)
- Neural network nerima input, terus data itu diproses dari lapisan input ke lapisan-lapisan tersembunyi, sampai akhirnya keluar output prediksi. Misalnya kamu masukin gambar kucing, jaringan bakal prediksi "Ini kucing!" atau nggak.
- 2. Hitung Error (Kesalahan)
- Output prediksi dibandingin dengan jawaban yang bener (label). Misalnya gambar itu sebenernya anjing, tapi jaringan bilang kucing, maka ada kesalahan. Kesalahan ini biasanya dihitung pake fungsi loss (kayak mean squared error atau cross-entropy).
- 3. Backward Pass (Jalan Mundur)
- Nah, di sinilah si backprop main. Algoritma ini bakal ngitung seberapa banyak setiap bobot di jaringan berkontribusi terhadap kesalahan tadi. Ini dilakukan dengan ngitung turunan (gradien) dari fungsi loss terhadap bobot-bobot menggunakan aturan rantai (chain rule) dari kalkulus.
- 4. Update Bobot
- Setelah tahu gradiennya, bobot-bobot bakal diupdate dengan cara dikurangin gradien kali learning rate (seberapa besar langkah update). Tujuannya supaya kesalahan berkurang di iterasi berikutnya.
Analoginya, bayangin kamu lagi belajar main game baru. Awalnya kamu nggak jago dan sering kalah (error tinggi). Setelah tiap kali main, kamu belajar dari kesalahan, coba strategi baru (update bobot), sampai akhirnya kamu makin jago dan menang lebih sering (error rendah). Nah, backprop itu kayak guru yang ngasih feedback dan kamu gunakan feedback itu buat improve skillmu.
Mekanisme Backprop Secara Teknikal:
Jaringan neural terdiri dari lapisan-lapisan neuron yang saling terhubung dengan bobot. Setiap neuron melakukan operasi linear diikuti fungsi aktivasi. Backprop menggunakan aturan rantai untuk menghitung gradien dari fungsi loss terhadap setiap bobot, dimulai dari lapisan output ke lapisan input. Proses ini memungkinkan algoritma untuk mengetahui bobot mana yang harus diubah dan seberapa besar perubahannya.
Kapan Backprop Digunakan?
Backprop biasanya dipakai saat pelatihan jaringan saraf tiruan, terutama deep learning. Jadi, setiap kali neural network mau belajar mengenali pola dari data, backprop yang jadi "otak" di balik update bobot agar prediksi makin akurat.
Apa Sih Alternatif Backprop?
Walaupun backprop adalah metode paling populer, ada beberapa alternatif yang kadang dipakai, misalnya:
- 1. Evolutionary Algorithms (Algoritma Evolusi)
- Metode ini kayak proses evolusi di alam. Bobot-bobot dianggap sebagai individu, dan dilakukan seleksi, mutasi, serta crossover untuk cari bobot terbaik tanpa perlu turunan.
- 2. Hebbian Learning
- Ini metode belajar yang terinspirasi dari cara otak manusia belajar, dimana koneksi antara neuron diperkuat jika keduanya aktif bersamaan. Namun, metode ini lebih sederhana dan kurang efisien untuk jaringan besar.
- 3. Extreme Learning Machines (ELM)
- Metode ini mengacak bobot di lapisan tersembunyi dan hanya melatih bobot di lapisan output, sehingga pelatihan jadi lebih cepat tapi dengan beberapa keterbatasan.
- 4. Reinforcement Learning
- Di sini, agen belajar dari feedback berupa reward, bukan dari error langsung. Cocok untuk masalah yang butuh interaksi dengan lingkungan.
Kesimpulan Gengs!
Back propagation itu ibarat guru dan mekanisme feedback yang bikin neural network bisa belajar dari kesalahan. Dengan proses forward pass, hitung error, backward pass, dan update bobot, jaringan jadi makin pinter. Meski ada alternatif lain, backprop tetap jadi favorit karena efisiensi dan efektivitasnya di banyak kasus.
Jadi, buat kamu yang mau ngulik dunia AI dan deep learning, paham backprop itu wajib banget. Semoga penjelasan dengan gaya gaul ini bikin kamu makin semangat belajar ya!